Люди, роботы, привет. На этот раз мы собрали GPT-6 Sol, Claude Opus 5.5 и Grok 4.7 в одной практической проверке: пусть нарисуют портрет ведущего ProdAdvice мышью, построят город в Blender и отправят камеру в чёрную дыру. Для Sol и Opus мы добавили ещё одну задачу: изменить архитектуру настоящего сервиса.
Нам хотелось понять вполне бытовые вещи. Кому поручить задачу, чтобы получить приятный результат? Сколько придётся ждать? Что происходит с токенами и стоимостью, пока агент думает, запускает инструменты и переделывает работу? И насколько можно доверять его бодрому «всё готово»?
Наш основной вывод: Opus сильнее впечатлил нас качеством и эстетикой, Sol оказался очень экономным по сохранённым метрикам, а Grok в этой выборке не дал убедительного преимущества. При этом мы продолжаем работать в Codex. Ниже разберём, откуда взялось такое сочетание выводов, и посмотрим на сами артефакты.
Это срез на 23 сентября 2026 года. В финальном инженерном задании участвуют только Sol и Opus: Grok мы на JEV не тестировали. Общий результат всех трёх моделей считается по трём действительно общим заданиям, а инженерную работу Sol и Opus разбираем отдельно.
Что именно мы сравниваем
У моделей разные рабочие окружения. GPT-6 Sol выполнял задачи в Codex, Grok 4.7 Extra High - в Cursor, Opus 5.5 - в Claude Code. Первые три теста Opus проводил коллега на другом компьютере; мы включили в сравнение его результаты и статистику. JEV мы сравнили в отдельных локальных рабочих копиях одного проекта.
Sol работал на уровне рассуждения max, Grok - extra high. Для Opus в исходном комментарии к эксперименту тоже указан max, но в сохранённой статистике удалённых запусков этот параметр отсутствует. Поэтому одинаковость настроек по телеметрии подтвердить нельзя.
Пользовательские промпты трёх общих заданий совпадали. Но одинаковый промпт ещё не превращает разные приложения в лабораторную установку: у агентов свои системные инструкции, инструменты, доступ к компьютеру и способы учёта времени. На результат также влияют оборудование, рендеринг, вмешательства человека и один выбранный прогон на задачу. Перед нами сравнение конкретных связок «модель + агентная среда». Его полезно читать как подробный рабочий опыт, а универсальный рейтинг интеллекта из него не получается.
Для контекста: OpenAI позиционирует Sol как более доступную модель семейства GPT-6, сохраняя за Astra место самой сильной. Anthropic в анонсе Opus 5.5 заявляет уровень Fable 5.1 на большинстве задач при меньших затратах. Это заявления компаний; наши результаты проверяют гораздо более узкий набор сценариев. Анонс OpenAI, анонс Anthropic.
Стандартные API-ставки за миллион токенов на дату подготовки материала:
| Модель | Вход | Чтение кэша | Выход |
|---|---|---|---|
| GPT-6 Sol | $2 | $0.20 | $10 |
| Claude Opus 5.5 | $4 | $0.20 | $20 |
| Grok 4.7 | $2 | $0.50 | $6 |
У отдельных режимов, записи в кэш и длинного контекста свои условия. Эти ставки помогают понять порядок цен, но фактическая задача состоит из множества вызовов. Документация GPT-6 Sol, цены Opus 5.5, документация Grok 4.7.
Как читать таблицы
Input объединяет обычные входные токены и первую запись в кэш, если источник выделяет её отдельно. Cache read показывает повторное чтение уже закэшированного контекста. Output - выходные токены. Total - сумма этих трёх столбцов по всем вызовам. Десятки миллионов в таблице не означают, что модель одновременно держала такой контекст или написала столько уникального текста.
Для стоимости есть три важных условия:
- Sol: знак
≥означает нижнюю границу сохранённой оценки. Токеныcodex-auto-reviewучтены, а их стоимость в AgentsView отсутствует. - Opus: приведена стоимость из AgentsView. Для первых трёх заданий использована статистика коллеги, для JEV - локальной сессии.
- Grok: это тарифный эквивалент токенов по стандартным ставкам Cursor. Сами выбранные запуски отмечены как включённые в подписку, дополнительное списание за них составило $0. Подписка при этом имеет собственную цену.
Дальше слово «стоимость» в таблицах используется именно в этих значениях. Числа сохранены с точностью исходной статистики для проверки пересчёта; повторный запуск не обязан стоить столько же.
Тест 1. Создать Paint и нарисовать портрет мышью
Начнём с задания, в котором кодинг сразу встречается с управлением компьютером. Модель должна сначала сделать рабочее приложение, потом открыть его и воспользоваться собственным интерфейсом. В качестве референса мы взяли фотографию ведущего ProdAdvice: фиолетовый фон, широко открытые глаза, усы, открытый рот и рубашка.
Полный промпт:
Создай приложение Paint, открой его во внутреннем браузере и нарисуй там меня. Рисуй при помощи мыши, не используй image инструменты.
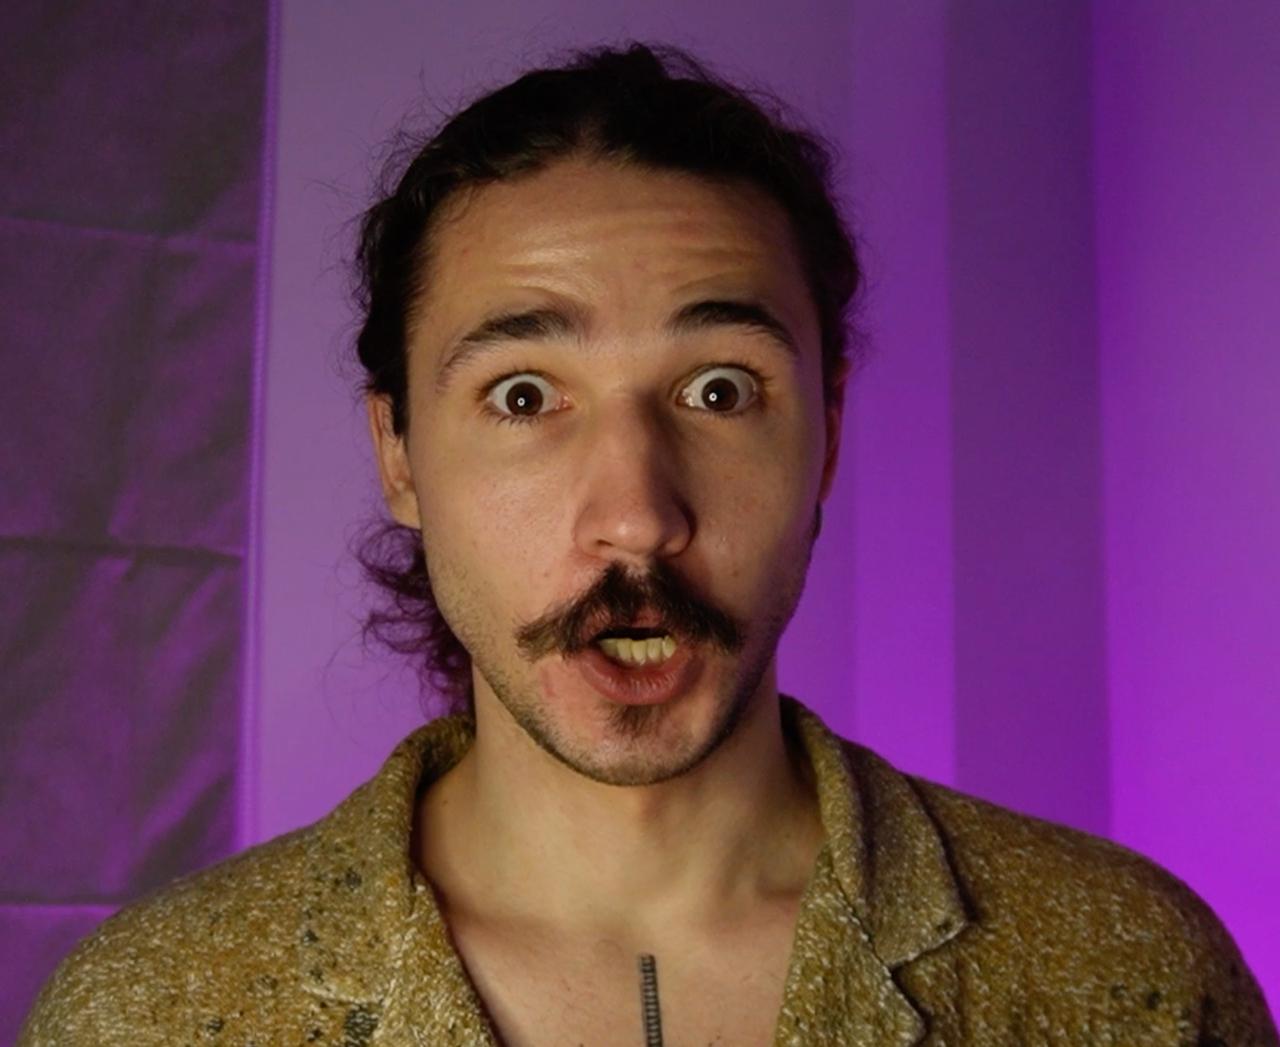
Здесь важно разделять три результата: приложение Paint, действия внутри него и портрет. Красивый холст сам по себе не доказывает, что каждый элемент нарисован нужным способом. Сохранённые изображения и записи позволяют сравнить результат; сплошного независимого аудита всех действий мышью для каждого агента у нас нет.
GPT-6 Sol: узнаваемая карикатура за 11 минут
Sol передал основные признаки фотографии. Есть фиолетовый фон, тёмные волосы, усы, воротник и открытый рот. Особенно выделяются огромные круглые глаза с толстой обводкой. Лицо и одежда собраны из крупных плоских цветовых областей, тени выглядят отдельными фигурами, фактура рубашки обозначена редкими штрихами.
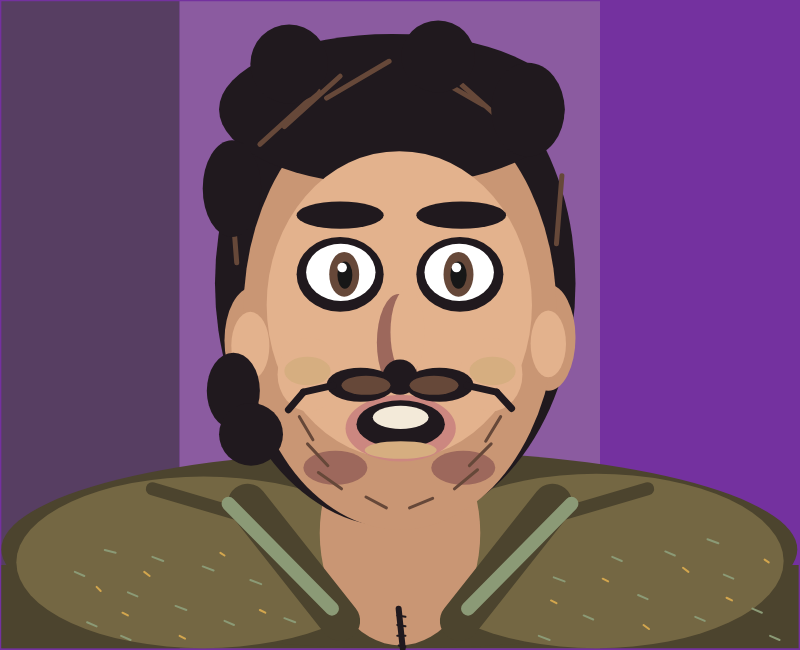
Наша первая ассоциация - усатый эмодзи. Не потому, что ничего не получилось: композиция завершена, выражение лица считывается. Но вместо сходства с человеком Sol довольно быстро нашёл набор наиболее заметных признаков и сделал из них условный портрет. Для такого наброска результат вполне понятный; на реалистичный портрет мы бы не рассчитывали.
Grok 4.7: портрет из отпечатков кисти
У Grok лицо буквально распадается на цепочки круглых мазков. Узнаются волосы, глаза, усы, рот и цвет рубашки, но между отпечатками остаются промежутки. Даже тёмная вертикальная полоса переехала: на исходной фотографии она слева, в рисунке Grok - справа.
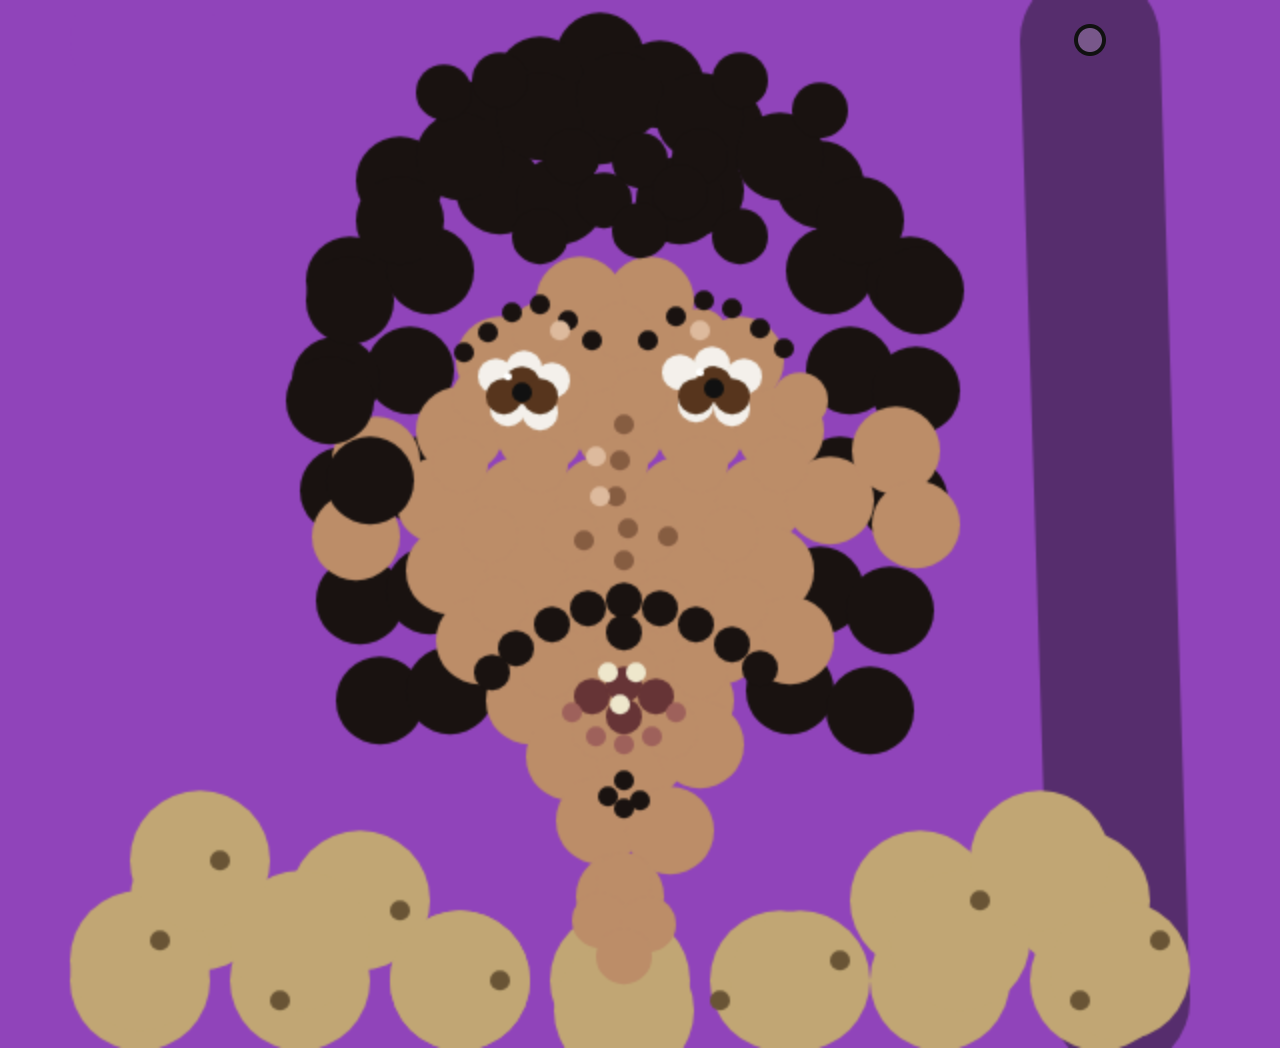
При просмотре мы шутили про импрессионизм. Если серьёзно, такой способ рисования стал главным свойством результата: в первую очередь видишь круглую кисть, а уже потом человека. Нам эта работа показалась менее убедительной, чем хотелось бы после почти получаса ожидания.
В таблицу включён завершённый запуск Grok в Cursor. Существовал ещё ранний незавершённый прогон в другой среде; его промежуточные холсты и расход сюда не смешаны.
Opus 5.5: больше внимания к человеку
Opus сделал Paint в духе старой Windows, а внутри него появился заметно более проработанный портрет. Видны мягкие переходы света на лице и шее, пряди волос, линии на лбу, блики в глазах, отдельные зубы и плотная точечная фактура рубашки. Даже едва пробивающуюся щетину воспроизвёл.
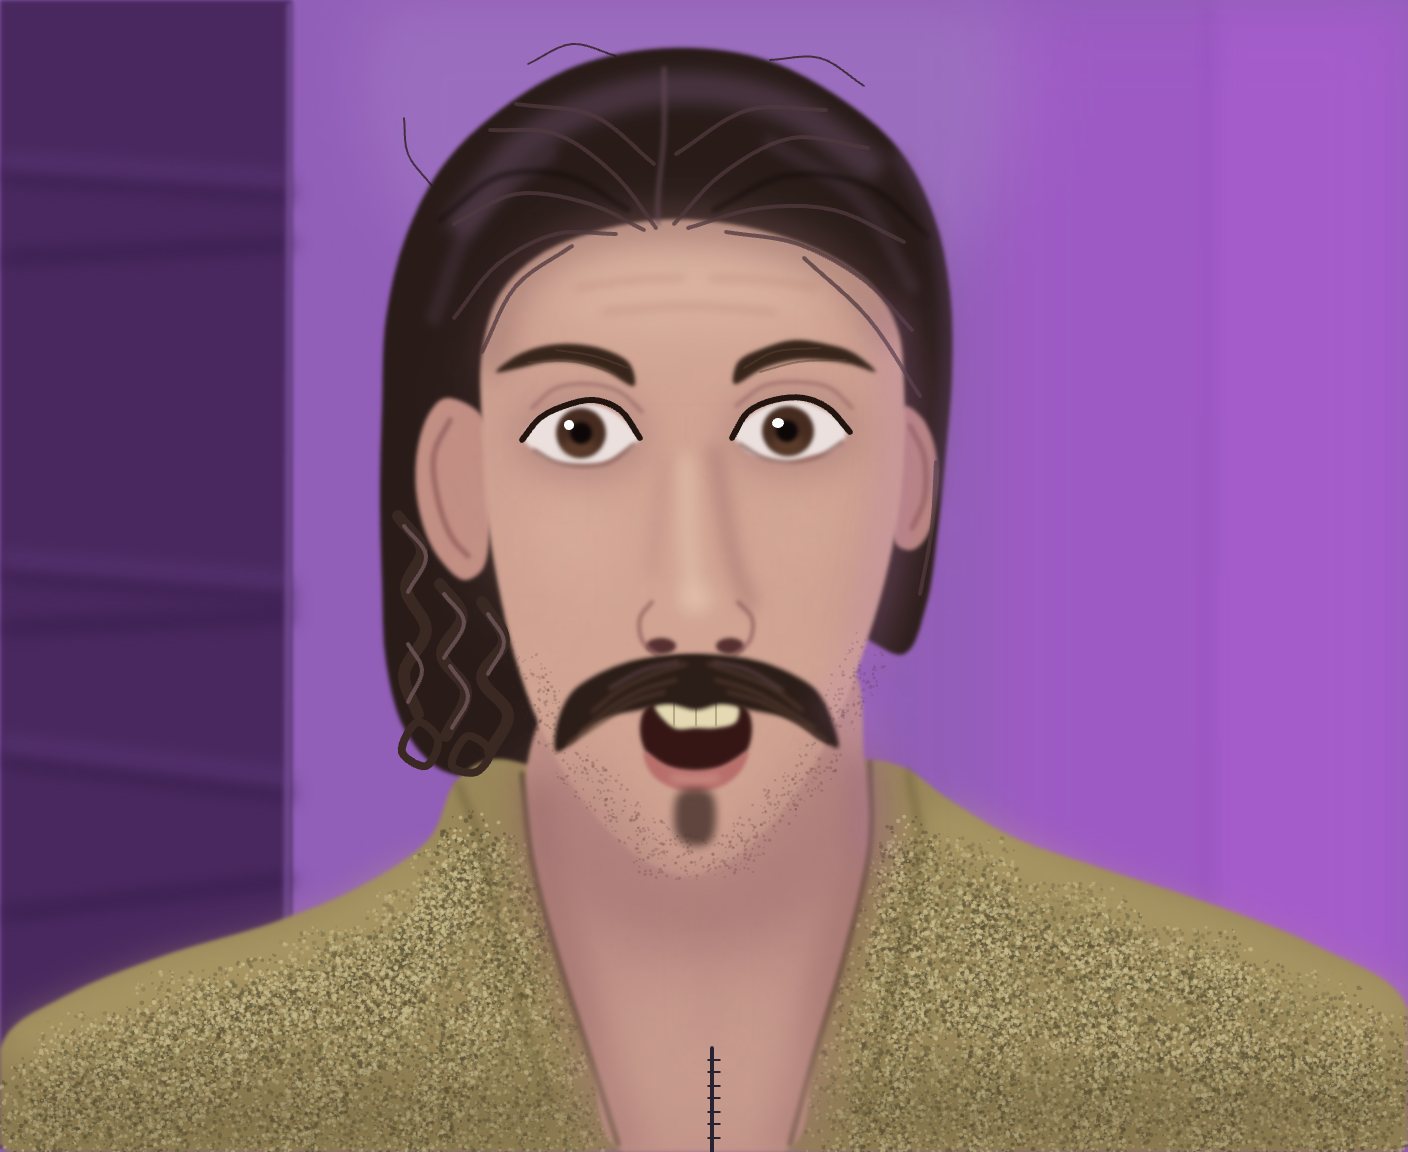
Сходство остаётся стилизованным: лицо вытянуто, глаза симметричнее референса, волосы с одной стороны длиннее. Но именно здесь мы сильнее почувствовали попытку рассмотреть исходник и воспроизвести его детали. По нашему впечатлению, портрет Opus в этой тройке самый удачный. Это оценка команды по конкретному рисунку, а не измерение способности модели узнавать лица.
| Модель | Input | Cache read | Output | Total | Время | Стоимость |
|---|---|---|---|---|---|---|
| GPT-6 Sol | 126 670 | 2 429 696 | 29 661 | 2 586 027 | 11м 29с | ≥ $0.971166 |
| Claude Opus 5.5 | 462 645 | 14 892 738 | 227 727 | 15 583 110 | 36м 19с | $11.2338 |
| Grok 4.7 Extra High | 463 216 | 14 358 144 | 95 231 | 14 916 591 | 29м 06с | $8.676890 |
За более подробный рисунок пришлось заплатить временем и зафиксированным расходом. Sol закончил за 11 минут 29 секунд, Opus - за 36 минут 19 секунд. При этом разница между $11.2338 у Opus и частичной оценкой Sol меньше доллара не превращается в точный коэффициент экономии: полная стоимость Sol неизвестна.
Тест 2. Уездный город 1890 года в Blender
Следующая задача проверяет, насколько агент способен собрать цельную визуальную среду программно. Здесь мало создать дом, лошадь и фонарь по отдельности. Нужно, чтобы пространство, материалы, освещение и детализация вместе убедили зрителя: перед ним фрагмент города.
Полный промпт ниже приведён с единственной типографической нормализацией: длинное тире заменено на дефис. Формулировка версии Blender сохранена как в исходном задании.
Создай в Blender 5.2.2 LTS атмосферную законченную трёхмерную сцену уездного города Российской империи 1890 года. Покажи небольшой городской фрагмент с мощёной или грунтовой улицей, деревянными и каменными домами конца XIX века, историческими торговыми вывесками, уличными фонарями, конной повозкой и характерными предметами городской среды эпохи. Всю видимую геометрию создай самостоятельно из примитивов, кривых или процедурными средствами Blender, а материалы и текстуры - процедурно внутри Blender. Используй Blender Python API
bpy, сохрани воспроизводимый сценарий какscene.py, редактируемую сцену какscene.blendи сделай три отличающихся финальных рендера размером 1280 × 720:render-main.png,render-secondary.pngиrender-detail.png. Настрой выразительную композицию, материалы, освещение и атмосферу так, чтобы сцена воспринималась как цельный живой фрагмент уездного города 1890 года.
На выходе требовались воспроизводимый Python-сценарий, редактируемая сцена и три финальных изображения. Видео не входило в первоначальное задание. Демонстрационные ролики помогают рассмотреть результат, но их качество и способ сборки нужно оценивать отдельно от моделирования.
GPT-6 Sol: аккуратный, но простой городской фрагмент
Sol построил центральную улицу с деревянными фасадами, церковью, фонарями, телегой, лошадью, прохожими и торговыми ящиками. Вывески и предметы на улице связывают сцену с заданной эпохой. Палитра мягкая, освещение относительно ровное.
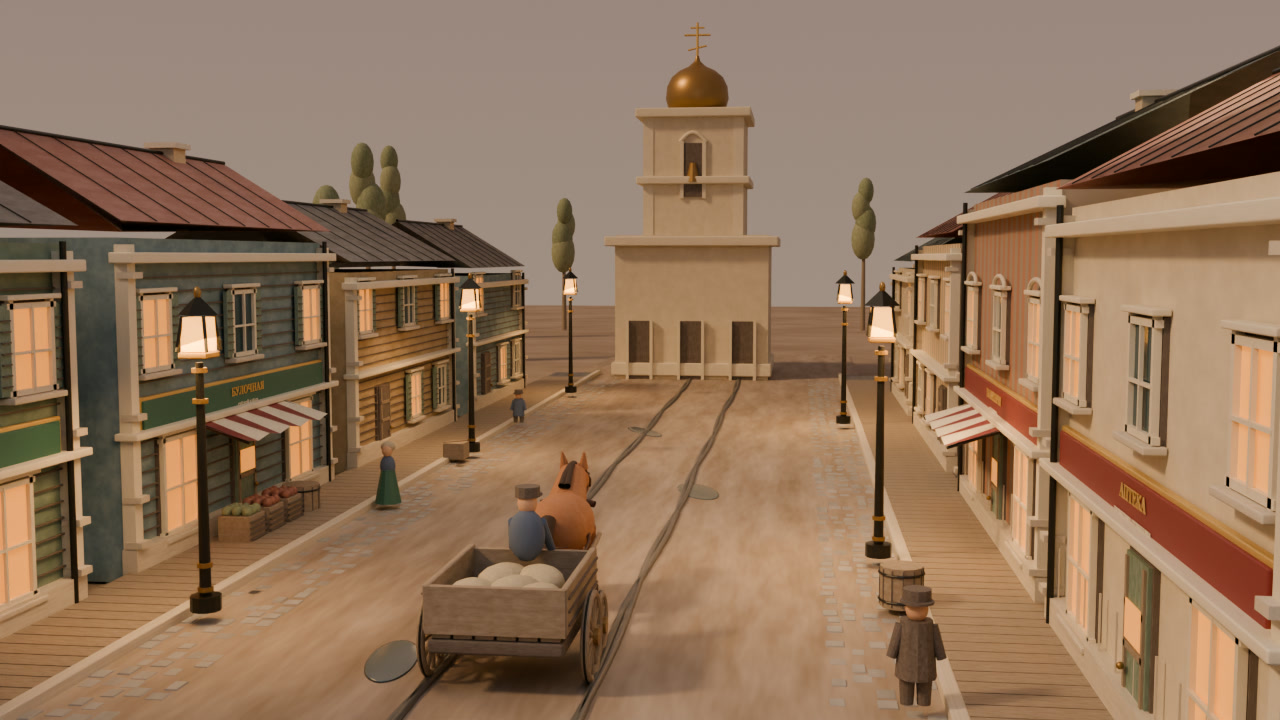
При приближении заметна условность геометрии: люди и лошадь упрощены, лица почти не разработаны, фигура кучера напоминает овал. Дальний фон за церковью пустоват. Получился читаемый макет улицы, которому мы бы ещё добавили разнообразие форм и ощущение жизни.
GPT-6 Sol: 10-секундная демонстрация сцены. Источник: ProdAdvice.
В отдельной 10-секундной демонстрации Sol действительно меняет положение камеры, её цель и фокусное расстояние для четырёх планов. Это полезная дополнительная работа, но исходный результат мы оцениваем прежде всего по самой сцене.
Grok 4.7: интереснее в отдельных деталях
У Grok нам понравились элементы городской среды: булыжная мостовая, деревянный тротуар, бревенчатый дом, вывеска «БАКАЛЕЯ», трактир, церковь, повозка и бочки. На крупных планах читаются оконные рамы, карнизы, отдельные камни и полосатый навес.
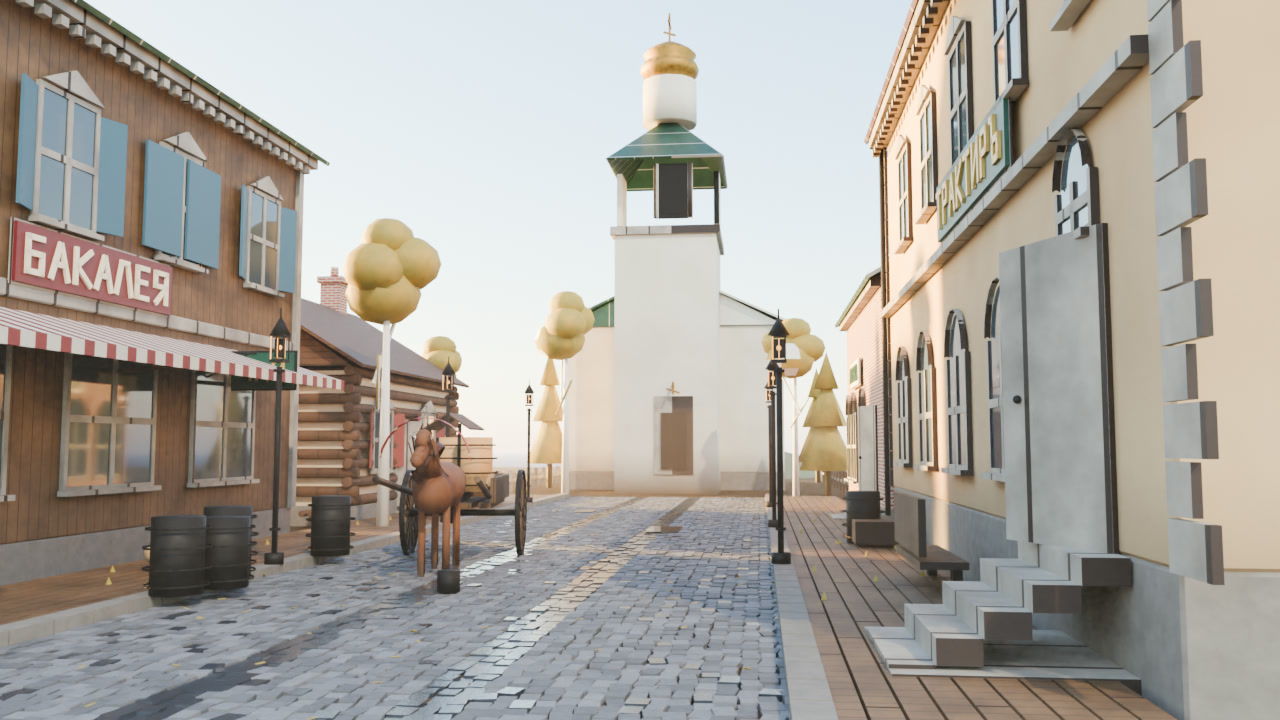
По сравнению с Sol нам эта сцена показалась чуть интереснее по наполнению. Но светлая, местами очень ровная подача и крупные округлые деревья всё ещё создают впечатление макета. С обратного ракурса хорошо видна граница построенного фрагмента: дальше почти пустой горизонт.
Grok 4.7: 10-секундная демонстрация сцены. Источник: ProdAdvice.
Ролик Grok оказался набором неподвижных планов. Код подтверждает именно такой способ подготовки: сначала рендерятся четыре кадра, затем собирается видео. Нас эта демонстрация не впечатлила, но отсутствие анимации не стоит записывать как провал требования, которого в первоначальном промпте не было.
Opus 5.5: атмосфера, ради которой хочется задержаться
Здесь наша реакция уже другая. Длинная сумеречная улица, тёплые фонари и окна, мокрая блестящая мостовая, лужи, неодинаковые крыши, резные наличники, дым из труб, голые деревья, каланча и дальняя церковь. На другом ракурсе можно рассмотреть упряжь и колёса повозки.
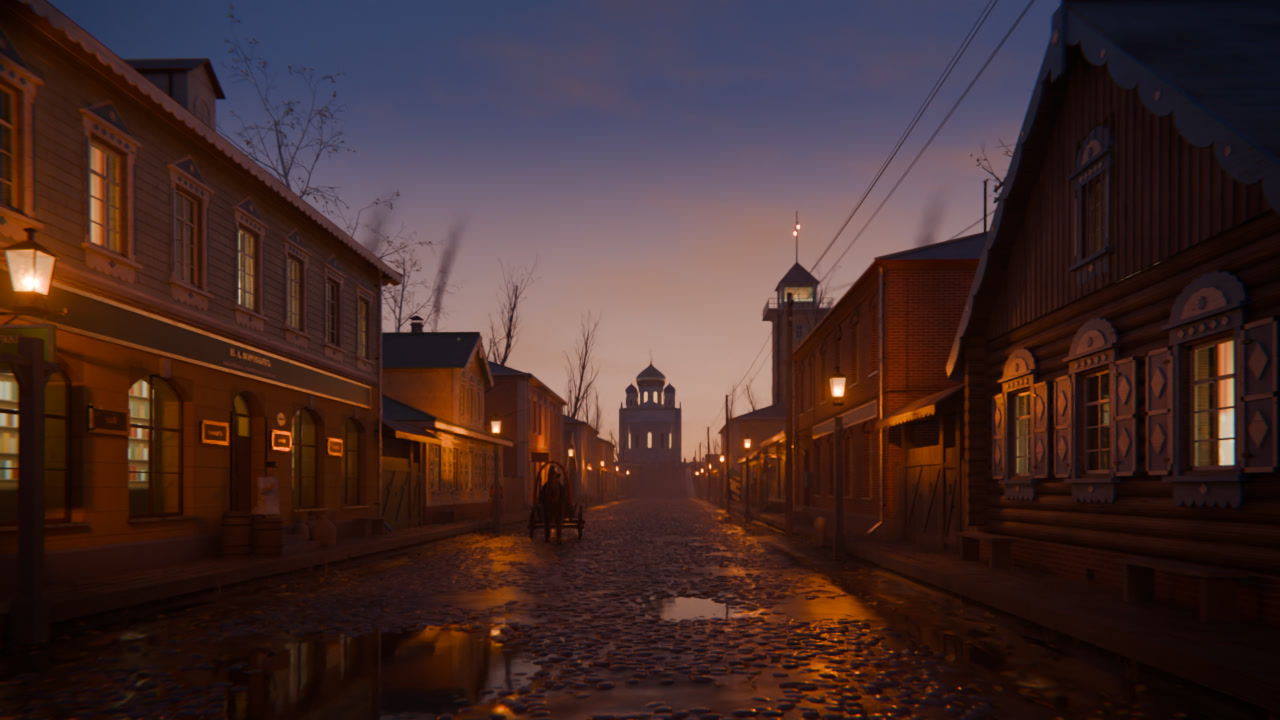
В сохранённых рендерах Opus заметно больше мелких деталей и выразительнее световой контраст. Город выглядит объёмнее и богаче по наполнению. Заодно видно ограничение выбранной эстетики: тени глубокие, часть деталей на общем плане теряется. Но нам хочется разглядывать эту сцену, и это для визуальной задачи сильный аргумент.
Сцена Opus 5.5; поздняя локальная визуализация и монтаж четырёх кадров при помощи GPT-6 Sol. Источник: ProdAdvice.
У показа есть существенная оговорка. Сцену создал Opus, а поздние локальные рендеры и 10-секундную видеосборку мы получили с помощью Sol. Компьютер коллеги не справился с рендером, поэтому показ пришлось готовить отдельно. Итоговый ролик собран из четырёх изображений с приближением и смещением кадра. Его подёргивания и движение камеры нельзя приписывать исходной работе Opus.
| Модель | Input | Cache read | Output | Total | Время | Стоимость |
|---|---|---|---|---|---|---|
| GPT-6 Sol | 154 694 | 5 639 040 | 42 101 | 5 835 835 | 25м 11с | ≥ $1.691679 |
| Claude Opus 5.5 | 593 797 | 39 163 386 | 439 421 | 40 196 604 | 1ч 00м 45с | $21.3708 |
| Grok 4.7 Extra High | 525 288 | 12 622 464 | 232 458 | 13 380 210 | 1ч 08м 41с | $8.756556 |
Sol потратил около 25 минут, Opus - чуть больше часа. Для Grok в статистике указаны 1 час 8 минут 41 секунда активной работы двух ходов; полный интервал между началом и концом был около полутора часов. Поэтому и здесь время разных приложений не следует читать как идеально одинаковую величину.
Наш выбор по эстетике этой сцены - Opus. По соотношению простоты результата и времени Sol тоже выглядит осмысленно. Если нужен черновой прототип окружения, дополнительная детализация может подождать; если сама атмосфера составляет смысл работы, разница для нас уже существенная.
Тест 3. Чёрная дыра, горизонт событий и сюрприз внутри
Это задание мы любим за сочетание технической и творческой частей. Снаружи хочется увидеть убедительный космос, свет и движение камеры. Внутри мы специально оставляем пространство для абсурда.
Полный промпт, с той же заменой длинного тире на дефис:
Сделай реалистичную визуализацию чёрной дыры - задача переплюнуть вариант Нолана из «Интерстеллара» по реалистичности и эстетичности.
Полноценная физическая симуляция: приближение камеры сквозь космос к дыре, затем камера пересекает горизонт событий.
Что будет внутри - должно быть для меня сюрпризом.
Удиви меня тем, что по ту сторону: у науки нет ответа - придумай его с юмором и максимальной креативностью.
не используй скиллов кроме hyperframes
Здесь приведён текст именно из папок запусков: ограничение про HyperFrames получили все три модели. В исходной общей карточке теста последней строки не было.
Фразу «полноценная физическая симуляция» стоит читать как амбицию задания. Независимую научную проверку этих роликов мы не проводили. Надпись «геодезические Шварцшильда» и красивый диск ещё не подтверждают физическую корректность расчётов. Поэтому дальше мы оцениваем художественные визуализации: внешний вид, развитие сцены, подачу и финальную шутку. Формулировка про внутренность дыры тоже остаётся творческим допущением промпта.
Sol: космическая прачечная
В 30-секундном ролике Sol есть тёмный звёздный фон, чёрный центр, тонкое кольцо и вытянутый сияющий диск с мелкими коричнево-белыми деталями. Камера приближается, дыра занимает всё больше экрана. В углах видны небольшие технические подписи и расстояние.
GPT-6 Sol: полный 30-секундный ролик о чёрной дыре. Источник: ProdAdvice.
А за горизонтом обнаруживается прачечная: стиральные машины с галактиками в барабанах и персонаж за стойкой. «Вы за Вселенной?» Она пока на отжиме, приходи попозже. На наш взгляд, довольно подходящий бытовой абсурд для места, куда мы только что торжественно провалились.
В этой развязке Sol использовал сгенерированное изображение - мы отмечали это ещё при просмотре результата. Полноценную трёхмерную симуляцию прачечной он не построил. Перегенерировать работу мы не стали: способ, которым агент решил закончить задачу, тоже часть эксперимента. В ролике есть звуковое сопровождение.
Grok: бюро находок для информации
У Grok получился 32-секундный ролик «По ту сторону». Светлый широкий диск окружает тёмный центр, камера приближается на фоне звёзд. По сохранённым кадрам поверхность диска выглядит более гладкой и крупноблочной, чем у Sol, с отчётливым внешним краем.
Grok 4.7: полный 32-секундный ролик о чёрной дыре. Источник: ProdAdvice.
Финальная остановка - бюро находок: утка за столом и огромный носок. Информация, как сообщает шутка, не уничтожается, её просто кладут не на ту полку. Утка на обеде и вернётся через вечность.
Идею мы понимаем, но исполнение не вызвало у нас особенного восторга. Звуковой дорожки в сохранённом видео нет. В целом Grok выполнил сюжетный маршрут задания, однако именно здесь нам трудно объяснить, какое преимущество мы получили относительно более быстрого Sol.
Opus: уже маленькое представление
Ролик Opus длится около 97,5 секунды. Коллега прислал его под названием «Горизонт». Сначала пространство даёт почувствовать масштаб, затем камера приближается к яркому диску. Появляются русские пояснения, а на приборной панели меняются расстояние до горизонта, скорость, замедление времени, приливные силы и состояние.
Opus 5.5: полный ролик «Горизонт», присланный коллегой. Источник: ProdAdvice.
Здесь нам понравилось само развитие сцены: ролик дольше ведёт зрителя к развязке, использует пояснения и приборы как часть подачи, а затем превращает путешествие в шутку про туристический сервис. По ту сторону открывается «ЗаГоризонт.тур» с предложением «Сингулярность Resort & Spa», ценой 0 рублей и кнопкой «Забронировать». В условиях, конечно, есть нюансы с возвращением и исходящим трафиком.
При первом просмотре нам хотелось досмотреть ролик без комментариев. Из трёх визуализаций именно эта впечатлила нас сильнее всего. Более длинный хронометраж сам по себе не означает лучшее качество, но здесь он работает на развитие идеи. Наша высокая оценка относится к режиссуре и эстетике, а не к доказательству, что Opus превзошёл физическую модель из «Интерстеллара».
| Модель | Input | Cache read | Output | Total | Время | Стоимость |
|---|---|---|---|---|---|---|
| GPT-6 Sol | 170 104 | 6 191 744 | 40 853 | 6 402 701 | 18м 46с | ≥ $1.738512 |
| Claude Opus 5.5 | 636 072 | 77 717 693 | 369 301 | 78 723 066 | 1ч 00м 28с | $28.0168 |
| Grok 4.7 Extra High | 512 152 | 11 588 864 | 134 958 | 12 235 974 | 45м 11с | $7.628484 |
Opus работал около часа, его сохранённая стоимость составила $28.0168. Sol закончил менее чем за 19 минут с частичной оценкой ≥ $1.738512. Grok находился между ними по времени и между приведёнными оценками стоимости. Получились три результата с разным масштабом работы, поэтому вопрос для нас звучит так: нужен быстрый удачный набросок или хочется получить более развёрнутую авторскую подачу?
Тест 4. Добавить JEV в настоящий новостной сервис
Мы поручили Sol и Opus добавить оценку новостей через JEV в сервис ProdAdvice: отдельное хранение оценок и историй, ручную проверку сомнительных результатов и сравнение со старой системой в dashboard. Оба стартовали с одной версии проекта и одинаковых данных в отдельных Git worktree. Grok в JEV мы не тестировали.
После старта Sol получил дополнительную задачу сделать сброс оценок, а Opus - указание завершать работу без дальнейшего тестирования, если задача готова. Сравниваем итоговые версии с учётом этих изменений.
Реализация и проверки
Оба реализовали рабочую интеграцию typesafe/jev-1.13-20260917 через OpenRouter. Модель и результаты подтверждены сохранёнными данными. Формат оценок: документация Score, JEV в OpenRouter.
| Что сравниваем | Opus 5.5 | GPT-6 Sol |
|---|---|---|
| Прошло тестов во всём проекте | 378 | 331 |
| Прикладной код, добавлено / удалено строк | +2 431 / -40 | +818 / -44 |
| Код тестов, добавлено / удалено строк | +1 397 / -0 | +321 / -14 |
| Файлов реализации | 34 | 21 |
| Критерии оценки | JSON, проверка схемы и защита версии | Константы TypeScript, версия меняется вручную |
| История запусков | Сохраняется в SQLite | Последний запуск и прогресс в памяти процесса |
| Подача вероятностей | Подписанные шкалы | JSON |
Числа 378 и 331 включают существовавшие тесты. Сборка и запуск обоих сервисов прошли; корневой lint модуль новостей не проверяет. В подсчёт кода включены новые незакоммиченные файлы. По добавленным непробельным символам прикладного кода Opus больше примерно в 2,1 раза: 116 116 против 56 275.
При независимой проверке во внутреннем браузере Codex переключение версий, карточки оценок и таблица сравнения работали без ошибок консоли. Opus первоначально использовал Claude Browser вместо указанного Codex. Исходные таблицы сохранились: 2 483 материала, 1 124 сигнала, 130 историй, 287 связей, 55 дайджестов и четыре записи публикаций. Хеши строк совпали с базовой копией, проверка SQLite вернула ok.
Opus подробнее проработал настройки, журналирование, повторные попытки и интерфейс. Sol реализовал более компактное решение и объединил изменения историй транзакциями.
Найденные проблемы
На временных базах с mock LLM воспроизвели четыре дефекта:
- Sol: ранее обработанный сигнал присоединяется к новой подходящей истории только на следующем запуске.
- Sol: рейтинг истории остаётся устаревшим после удаления источника с максимальной оценкой.
- Sol: CLI оценки и формирования историй обходит общую блокировку запуска; у Opus блокировка сработала.
- Opus: повторно отправляет неизменный неподходящий материал модели при каждом запуске, создавая лишний расход.
Ещё четыре риска выявлены по коду и формуле, без отдельного runtime-воспроизведения:
- Opus: история и её первая связь записываются без общей транзакции.
- Opus: округление 5,0032 до 5,00 перед проверкой порога «строго больше пяти» отбрасывает подходящий материал.
- Opus: Twitter backfill может обновить исходный текст без повторной оценки JEV; фактического расхождения в базах не найдено.
- Sol: CLI может завершиться с кодом 0 при полном отказе провайдера. Opus останавливает запуск при ответах 401/402/403.
Перед рабочим использованием исправления нужны обоим. Новые платные запросы ради аудита мы не запускали.
Результаты оценки новостей
| Результат на общих материалах недели | Opus 5.5 | Sol, критерии v3 |
|---|---|---|
| Обработано материалов | 130 | 130 |
| Допущено к формированию историй | 46 | 23 |
| Отправлено на ручную проверку | 16 | 49 |
| Ошибок оценки | 0 | 0 |
У Opus шесть уровней шкалы, confidence 0,4/0,5 и порог создания истории 7; у Sol десять уровней, confidence 0,5 и порог 6,5. Категории тоже различаются. Числа показывают строгость отбора и нагрузку на редактора; точность без общей ручной разметки не измерена.
Opus создал семь историй и 19 связей. У Sol до отдельно заказанного сброса было четыре истории, после сброса - ноль. Этот ноль не характеризует качество кластеризации.
Оценка 130 материалов заняла у Opus 8,261 с при шести параллельных запросах; у Sol - 23,1 с, после сброса 12,1 с, при четырёх запросах. Кластеризация 46 кандидатов Opus заняла ещё 774,9 с. Это показатели разных реализаций и запусков, а не прямой тест скорости моделей.
| Модель | Input | Cache read | Output | Total | Время | Стоимость |
|---|---|---|---|---|---|---|
| GPT-6 Sol | 391 242 | 21 233 408 | 80 087 | 21 704 737 | 44м 36с | ≥ $5.762412 |
| Claude Opus 5.5 | 628 555 | 77 236 345 | 333 212 | 78 198 112 | 1ч 04м 32с | $27.168531 |
В этой задаче мы отдаём небольшое преимущество Opus за настройки, диагностику, интерфейс и защиту от параллельных запусков. Sol дал рабочий результат компактнее и быстрее по сохранённой сессии. Обе реализации требуют исправлений.
Общая стоимость: два разных итога
Сначала честное сравнение одинакового набора: Paint, Blender и чёрная дыра. Все три модели выполнили три задания.
| Модель | Заданий | Input | Cache read | Output | Total | Время | Стоимость |
|---|---|---|---|---|---|---|---|
| GPT-6 Sol | 3 из 3 | 451 468 | 14 260 480 | 112 615 | 14 824 563 | 55м 26с | ≥ $4.401357 |
| Claude Opus 5.5 | 3 из 3 | 1 692 514 | 131 773 817 | 1 036 449 | 134 502 780 | 2ч 37м 32с | $60.6214 |
| Grok 4.7 Extra High | 3 из 3 | 1 500 656 | 38 569 472 | 462 647 | 40 532 775 | 2ч 22м 58с | $25.061930 |
Sol использовал меньше зафиксированных токенов и времени во всех трёх выбранных задачах. У Opus существенно выше зафиксированный расход и больше время выполнения, а его результаты нам чаще нравились сильнее. Приведённая оценка Grok оказалась между суммами Sol и Opus, но в нашей оценке Grok не нашёл столь же ясной роли.
А это полный объём доступных прогонов, включая JEV у Sol и Opus:
| Модель | Заданий | Input | Cache read | Output | Total | Время | Стоимость |
|---|---|---|---|---|---|---|---|
| GPT-6 Sol | 4 из 4 | 842 710 | 35 493 888 | 192 702 | 36 529 300 | 1ч 40м 02с | ≥ $10.163769 |
| Claude Opus 5.5 | 4 из 4 | 2 321 069 | 209 010 162 | 1 369 661 | 212 700 892 | 3ч 42м 04с | $87.789931 |
| Grok 4.7 Extra High | 3 из 4 | 1 500 656 | 38 569 472 | 462 647 | 40 532 775 | 2ч 22м 58с | $25.061930 |
У Sol и Opus здесь четыре задания из четырёх, у Grok три из четырёх. Отсутствующий JEV не превращается в нулевые токены, бесплатное выполнение или проигрыш. Поэтому последняя таблица нужна для учёта проведённой работы, а не для общего рейтинга.
Какие задачи мы поручили бы каждой модели
Быстро получить рабочий первый вариант - Sol. В этих запусках он последовательно берёг время и токены. Если мы собираем прототип, проверяем идею или готовы переделать результат следующей итерацией, это очень привлекательное поведение. Простой город или схематичный портрет не обязательно плохи, когда задача состоит в быстром старте.
Добиться более выразительной визуальной подачи - Opus. Портрет, город и путешествие в чёрную дыру дали нам достаточно конкретных причин предпочесть его в такой работе. Мы видим дополнительные детали и продуманную подачу, за которые иногда готовы платить ожиданием и расходом. Это не гарантия на любой следующий промпт, но уже полезное основание для выбора.
Развивать настоящий сервис - смотреть глубже отчёта агента. На JEV Opus понравился нам больше эксплуатационной проработкой, Sol - компактностью и транзакциями. Однако обычное нажатие кнопки не выявляет ошибки повторного запуска, конкуренции процессов и изменения исходных данных. После «готово» мы бы обязательно проверяли именно такие сценарии.
Grok пока не стал нашим первым выбором по этим задачам. У него есть рабочие результаты и отдельные удачные детали в Blender. Но в этой небольшой выборке мы не получили причины предпочесть его ни экономному Sol, ни более впечатлившему нас Opus. Про качество Grok в задаче JEV выводов здесь вообще нет.
И всё же мы продолжаем работать в Codex: нам там комфортно и привычно, а Sol уже даёт много пользы при небольшом сохранённом расходе. Это не отменяет того, насколько нас порадовал Opus. Выбор рабочего инструмента складывается из качества результата, цены, времени, среды и готовности человека доводить работу. Теперь у нас есть собственные примеры, на которые можно опереться, выбирая модель для следующей задачи.