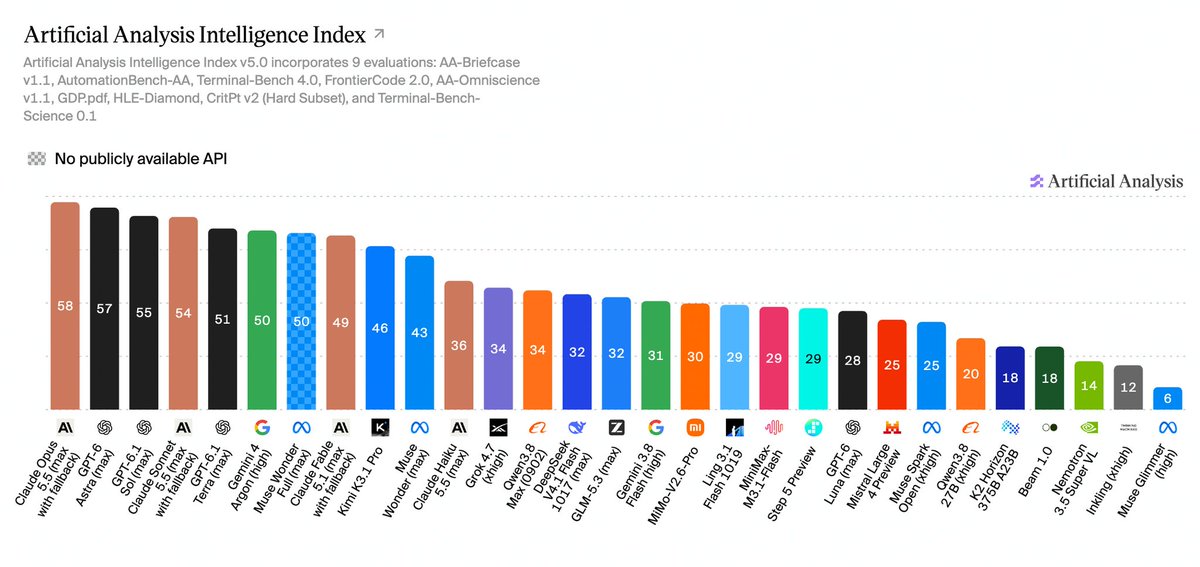
Независимая студия Artificial Analysis выпустила пятую версию Intelligence Index – сводного рейтинга возможностей языковых моделей. Это её крупнейшее обновление с января: 60% итоговой оценки теперь приходится на тесты с закрытыми наборами задач или непубликованными ответами. Впервые большинство рейтинга построено на данных, которые разработчики моделей не видят заранее. Одновременно вышел и отдельный Progress Index – шкала для сравнения моделей, выпущенных с ноября 2022 года.
Зачем закрывать тесты
Публичные бенчмарки со временем обесцениваются: их вопросы и ответы попадают в обучающие данные новых моделей, и тогда высокий балл измеряет память, а не умение. Поэтому ключевые оценки v5 закрыты. Новая кодинг-оценка FrontierCode 2.0, которую для индекса подготовила компания Cognition, построена именно так: агент должен внести изменение в реальный open-source репозиторий, а зачёт выставляется по критерию «приняли бы авторы проекта такое изменение в код». Попытка, провалившая хотя бы один блокирующий тест, приносит ноль, а задачи остаются закрытыми, чтобы избежать «загрязнения» – знакомства модели с правильными ответами ещё до теста.
Что вошло и что вышло
Индекс – взвешенное среднее по девяти оценкам в четырёх равных категориях: работа со знаниями, код, наука и общие вопросы. Помимо FrontierCode 2.0 в нём появилась Terminal-Bench-Science: 70 задач из пяти научных областей, в которых AI-агент выполняет настоящие исследовательские рабочие процессы в терминале. Каждую задачу готовят и проверяют эксперты, зачёт засчитывается только при прохождении всех проверок.
Три оценки обновили. HLE-Diamond заменила Humanity's Last Exam: это очищенная версия того же экзамена на 1000 вопросов, поровну разделённая между заданиями на рассуждение и на знание. AA-Omniscience v1.1 – обновлённая база вопросов на фактические знания и галлюцинации: из неё убрали слишком лёгкие и публичные вопросы, добавили новые и исправили двусмысленные. Бенчмарк по исследовательской физике CritPt v2 теперь оценивается на закрытом «жёстком» наборе из 40 задач: из исходных 70 убрали 30, которые на момент релиза семь топовых моделей решили во всех пяти попытках. Свои места сохранили AA-Briefcase, AutomationBench-AA, GDP.pdf и Terminal-Bench 4.0; выбыли GDPval-AA, SciCode и AA-LCR. По методологии студии, оценки выводят из индекса, когда перестают различать лидирующие модели, – поэтому каждая версия измеряется на своём наборе задач.
Сам рейтинг текстовый и англоязычный: работу с изображениями, речью и другими языками студия меряет отдельными оценками вне индекса. Задачи v5 к тому же заметно тяжелее в работе: медианное число сгенерированных токенов на задачу выросло на две трети, с 35 до 59 тысяч, – основной объём дают агентные оценки, где модель много шагов подряд работает с инструментами.
Кто наверху
Claude Opus 5.5 (max) возглавил рейтинг с 58 очками, следом идут GPT-6 Astra (max) с 57 и GPT-6.1 Sol (max) с 55. Первую пятёрку целиком занимают модели Anthropic и OpenAI; лучшая модель Google, Gemini 4 Argon (high), набирает 50. Абсолютного лидера по всем девяти оценкам нет: Opus 5.5 впереди по трём, остальные шесть распределили между собой ещё пять моделей. GPT-6 Astra, к примеру, лучше всех в обеих научных оценках – Terminal-Bench-Science (63%) и жёстком наборе CritPt v2 (72%), а Terminal-Bench 4.0 прошла Kimi K3.1 Pro (67%).
Разрыв с открытыми моделями вырос вчетверо
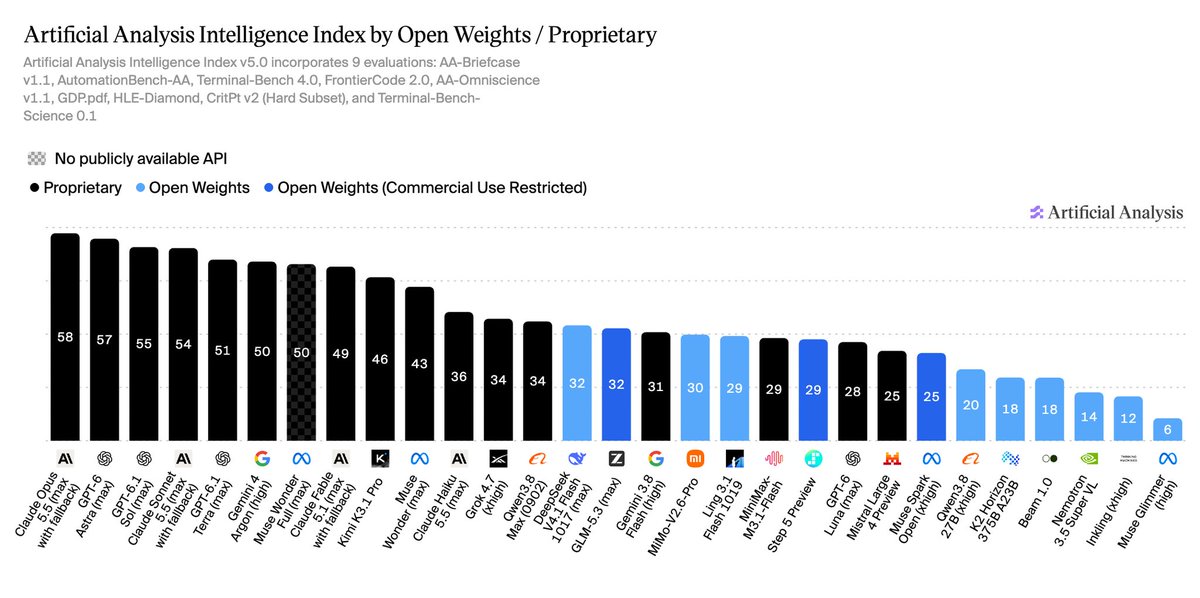
Лучшая модель с открытыми весами Kimi K3.1 Pro набрала 46 очков – на 12 позади лидера, тогда как в предыдущей версии разрыв составлял 3 очка. Оговорка существенная: веса K3.1 Pro ещё не опубликованы. Среди моделей с уже доступными весами впереди DeepSeek V4.1 Flash 1017 (max) и GLM-5.3 (max) – по 32 очка, на 26 позади лидера и ниже, чем Claude Haiku 5.5 (max) с его 36. Сильнее всего разрыв в новых сложных оценках: на HLE-Diamond Kimi набирает 37% против 68% у Opus 5.5, на Terminal-Bench-Science – 34% против 63% у GPT-6 Astra. Лучшая из открытых моделей с опубликованными весами на этих научных задачах набирает лишь 13%, а большинство не дотягивает даже до 10%.
Цена одного результата отличается в 13 раз
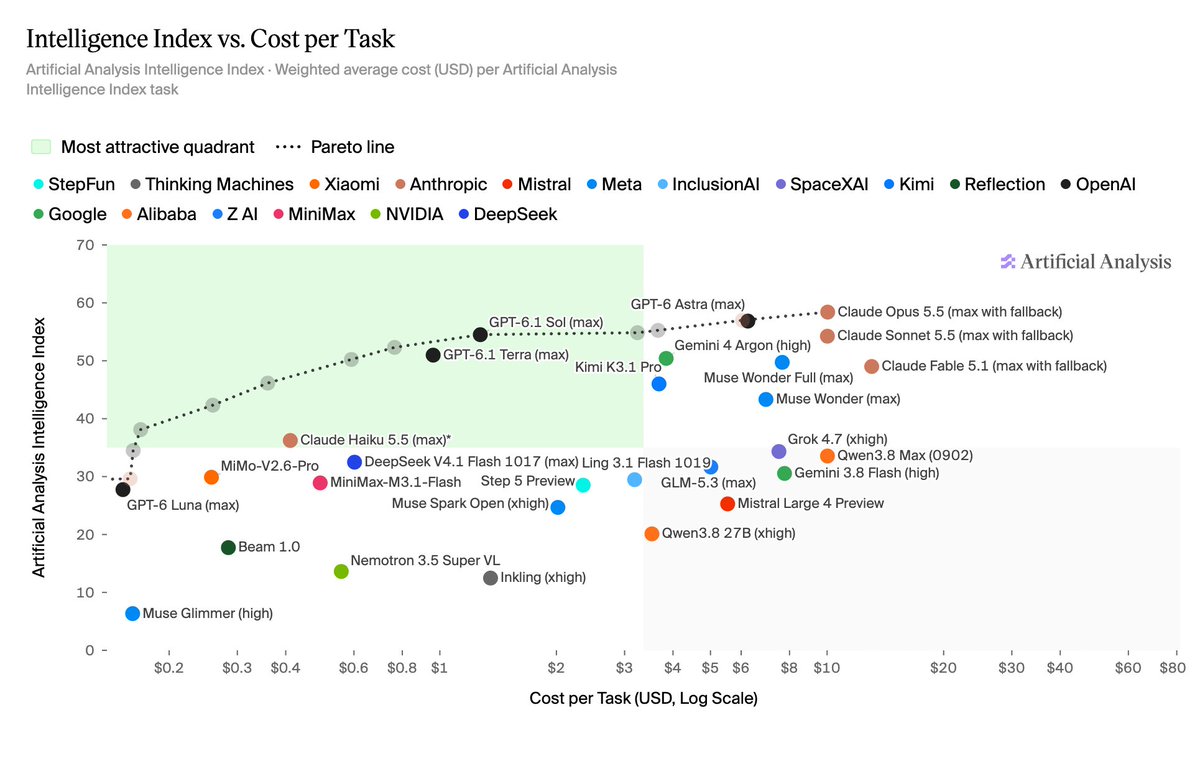
Среди десяти самых результативных моделей стоимость одной задачи рейтинга различается более чем в 13 раз: от $0.96 у GPT-6.1 Terra (max) до $13.04 у Claude Fable 5.1 (max). GPT-6.1 Sol (max) набирает 55 очков за $1.27 за задачу – на 4 очка меньше Opus 5.5 примерно за восьмую часть цены ($10.04). Стоимость зависит и от настройки уровня усилий – того, сколько вычислений модель тратит на один ответ: Opus 5.5 на минимальных усилиях набирает 35 очков, на максимальных – 58, но второй вариант в десять раз дороже ($0.98 против $10.04 за задачу). Этот разброс в v5 вырос: у Claude Sonnet 5.5 разница между минимальными и максимальными усилиями достигла 29 очков против 20 в прошлой версии, у GPT-6.1 Sol удвоилась с 10 до 20.
Progress Index: одна шкала для четырёх лет прогресса
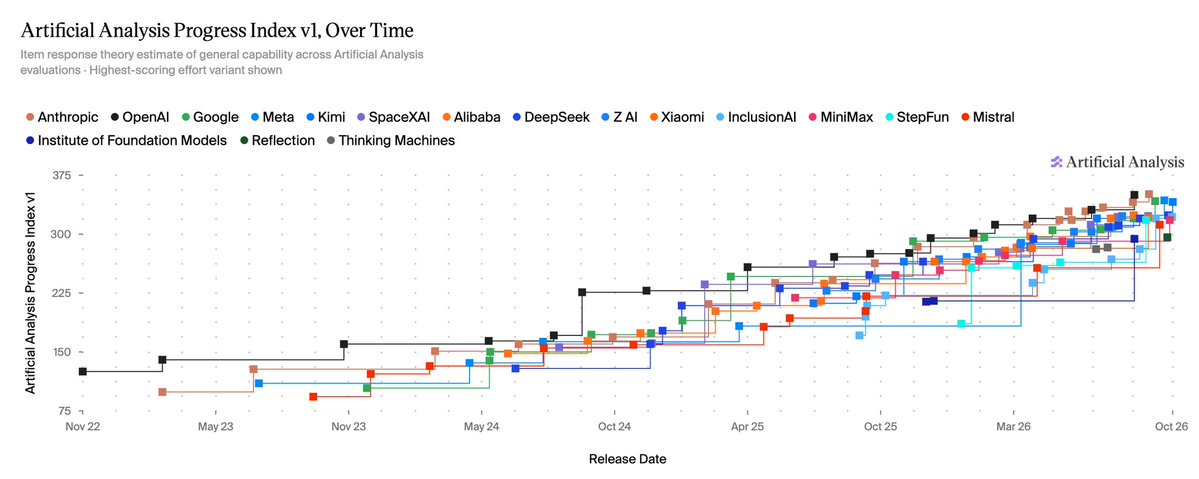
У Intelligence Index есть встроенное ограничение: поскольку состав меняется от версии к версии, баллы разных версий не предназначены для долгосрочных сравнений. Чтобы следить за развитием технологий, Artificial Analysis запустила Progress Index v1 – единую шкалу возможностей для моделей, выпущенных с ноября 2022 года. Внутри работает статистическая модель, которая одновременно оценивает силу каждой модели и сложность каждой задачи: бенчмарки, которые проходили одни и те же модели, сцепляют все результаты в общую шкалу. Благодаря этому сопоставимы даже модели, которые никогда не встречались с одними и теми же задачами. Студия разделяет назначение двух инструментов так: Progress Index – для анализа прогресса во времени, а Intelligence Index остаётся основной мерой при выборе модели под текущие задачи.
Источники
- Анонс Intelligence Index v5 – Artificial Analysis
- FrontierCode 2.0 – Artificial Analysis
- Terminal-Bench-Science – Artificial Analysis
- CritPt v2 (Hard Subset) – Artificial Analysis
- Лидеры отдельных оценок v5 – Artificial Analysis
- Открытые веса против проприетарных моделей – Artificial Analysis
- Стоимость задачи в Intelligence Index – Artificial Analysis
- Влияние уровня усилий на результат – Artificial Analysis
- Потребление токенов в v5 – Artificial Analysis
- Веса категорий Intelligence Index v5 – Artificial Analysis
- Анонс Progress Index v1 – Artificial Analysis
- Artificial Analysis Progress Index v1 Methodology | Artificial Analysis