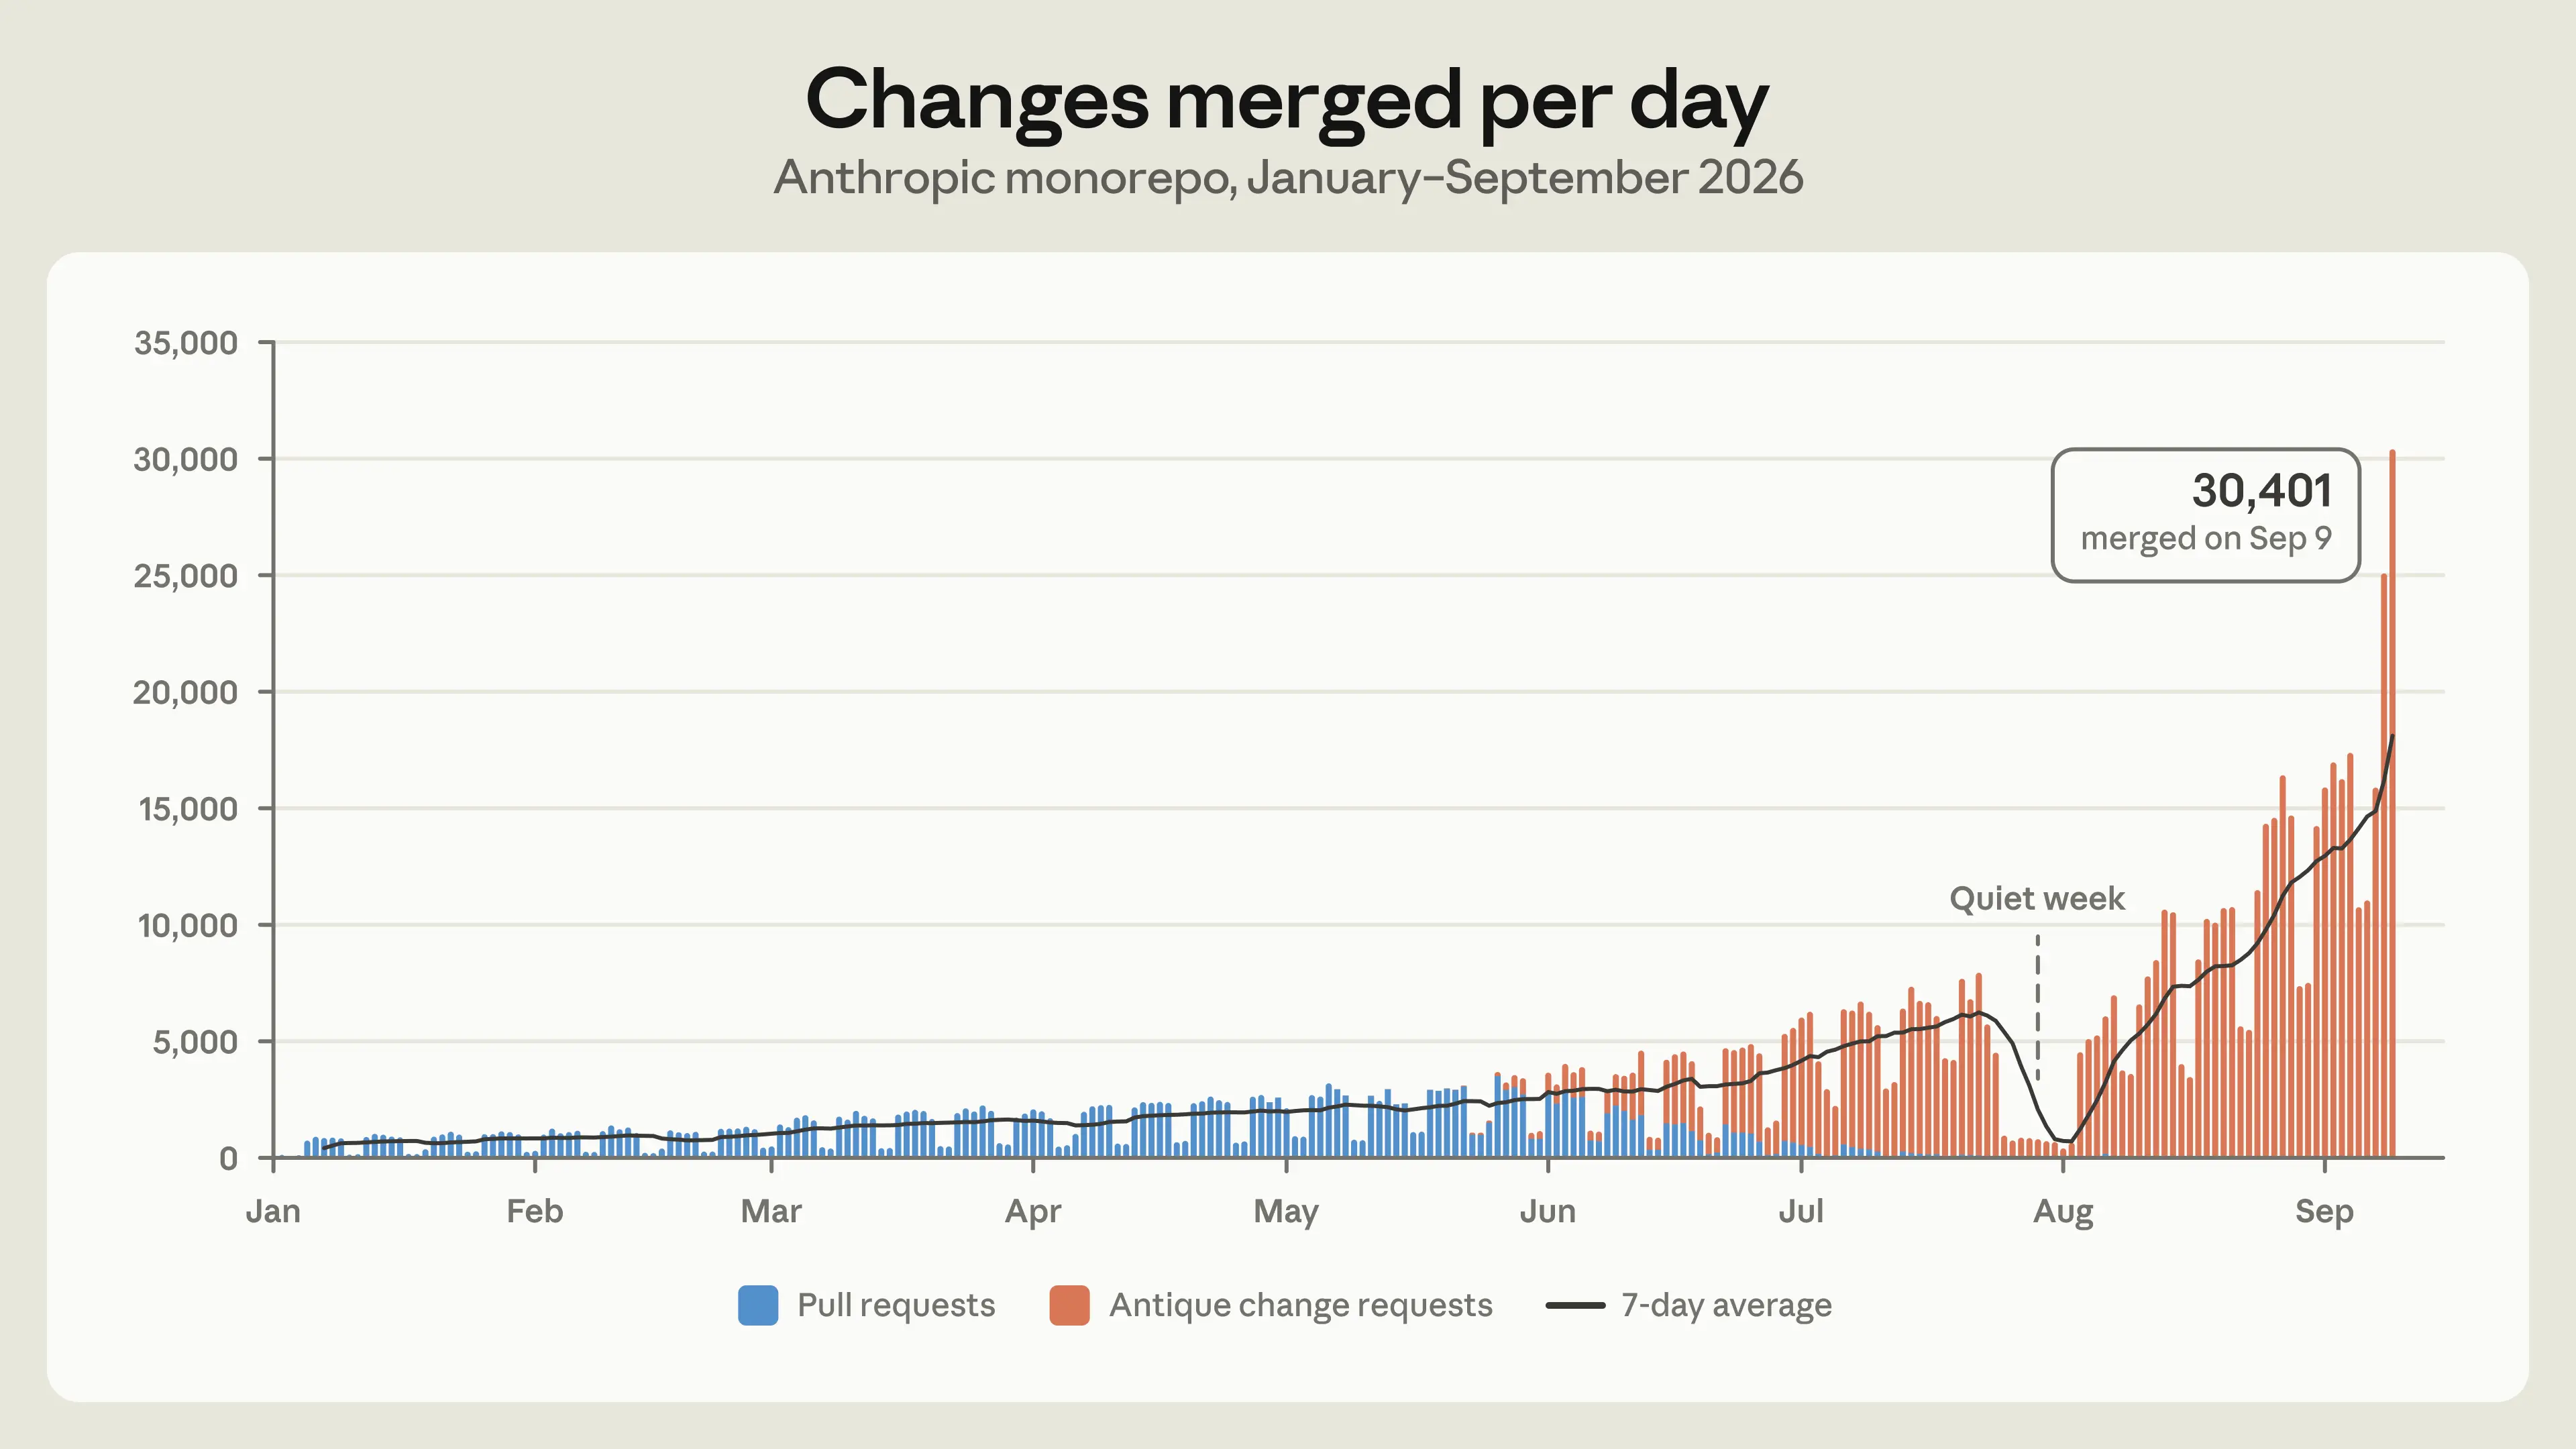
В мае 2026 года Anthropic вливала в свой монорепозиторий – единый репозиторий, где хранится весь код компании, – около 2 500 изменений в день. К сентябрю этот показатель превысил 30 000 изменений ежедневно. Писать код перестало быть узким местом: им стала инфраструктура, рассчитанная на людей, – система контроля версий, сборки и CI (автоматические проверки и сборки кода). Ответом стал Scion – собственная система контроля версий, на которую компания полностью перевела монорепозиторий с git за пять месяцев. Параллельно были построены инструмент ревью кода Antique, поиск по коду и система управления доступом.
Код в Anthropic пишет прежде всего Claude: по словам компании, модель автономно ведёт исследовательские циклы, оптимизирует программы и строит новые сервисы с невиданной прежде скоростью. Замедления в Anthropic не ждут: по их оценке, скрытый спрос на вливание кода практически бесконечен, и каждое устранённое узкое место сразу увеличивает объём производимого кода.
Почему git перестал справляться
Git децентрализован по замыслу: каждая копия – полноценный самостоятельный репозиторий, способный офлайн вычислять diff (сравнение версий), читать историю и выгружать любую ревизию. Для большинства репозиториев это правильный дизайн – одна из причин, почему git стал стандартом.
Монорепозиторий Anthropic в этот замысел перестал помещаться. История одной лишь главной ветки – почти 100 ГБ, сжатая рабочая копия – более 25 ГБ. Ежедневно код выгружается порядка 25 млн раз только для CI-задач – без учёта сред разработчиков, песочниц агентов и исследовательских задач. Если бы каждую такую выгрузку делать через git напрямую, трафик составил бы свыше 600 петабайт в день.
Стандартные обходные пути для больших монорепозиториев – внутренние зеркала и хранящиеся в облачном хранилище стартовые снимки репозитория – работали лишь до поры. В пике компания держала несколько сотен зеркал git. Это покупало время, но с ростом частоты слияний зеркала становилось всё тяжелее обслуживать, а зависящие от истории операции – diff и blame, определение того, кто последним менял строку, – всё сложнее поддерживать на частичных копиях.
Ключевое наблюдение: как и большинство компаний, Anthropic использует git как централизованную систему с одной авторитетной копией, но почти все её клиенты – агенты и задачи, которые по определению всегда онлайн. Именно свойства git, ценные для распределённой офлайн-работы, стали мешать масштабированию. Отсюда вопрос, с которого начался Scion: как выглядела бы система контроля версий, спроектированная под всегда доступный сервер с самого начала?
Как устроен Scion
Прямых аналогов у задачи немного, и Anthropic опиралась на опыт централизованных монорепозиториев Google (Piper) и Meta (Sapling). Главный сдвиг в дизайне прост: раз клиенты всегда онлайн, данные не нужно копировать целиком – их можно запрашивать у сервера по мере необходимости. Клиент Scion почти ничего не вычисляет сам и хранит мало: ограниченный локальный кэш и только нужные ему файлы. Выгрузки по умолчанию частичные – клиент забирает лишь запрошенные каталоги, а файлы появляются на диске по мере обращения, так что платить приходится только за реально прочитанное. Коммиты, слияния, rebase, вопросы об истории и blame – всё это делает сервер.
Основная единица работы – changeset, «набор изменений». Коммит в git хранит указатель на полное дерево проекта; changeset хранит лишь список изменившихся относительно родительской записи файлов и адреса их сжатого содержимого в облачном хранилище. Такой changeset создаётся на сервере и мгновенно доступен всем, а стоимость его создания зависит от размера изменения, а не от размера репозитория. Пушить нечего: каждый коммит, слияние и rebase происходят прямо на сервере.
Чтобы быстро отвечать на вопросы вроде «кто последним менял эту строку» или «какие коммиты затрагивали этот файл», сервер досчитывает по changeset'ам производные данные – отдельные структуры для blame и истории путей. Клиент видит только готовые ответы, поэтому внутренние структуры можно оптимизировать, не трогая клиентов.
Тем же клиентам больше не нужно заводить локальные копии репозитория, чтобы задать вопрос о коде: все запросы, которыми пользуется клиент, доступны и по API. На этом построены внутренние автоматизированные конвейеры – например, bisect (поиск коммита, вызвавшего поломку) и revert (откат изменений), которые на локальных копиях git в таком масштабе были бы непрактичны. Выгрузка не требуется и для многих записывающих операций: CI-задаче, которой нужен лишь diff между коммитами, достаточно запросить его у сервера.
Когда файлы всё-таки нужны на диске, работает многоуровневый кэш: локальный кэш узла запрашивает недостающее у регионального кэша, тот – у центральных серверов. Данные в Scion неизменяемы: записанный фрагмент больше не меняется, поэтому любой уровень может отдавать его из кэша, ни с кем не согласовываясь. Доля попаданий в кэш на каждом уровне превышает 99%, а полной материализованной копии репозитория нет нигде – даже на сервере.
Что дала миграция
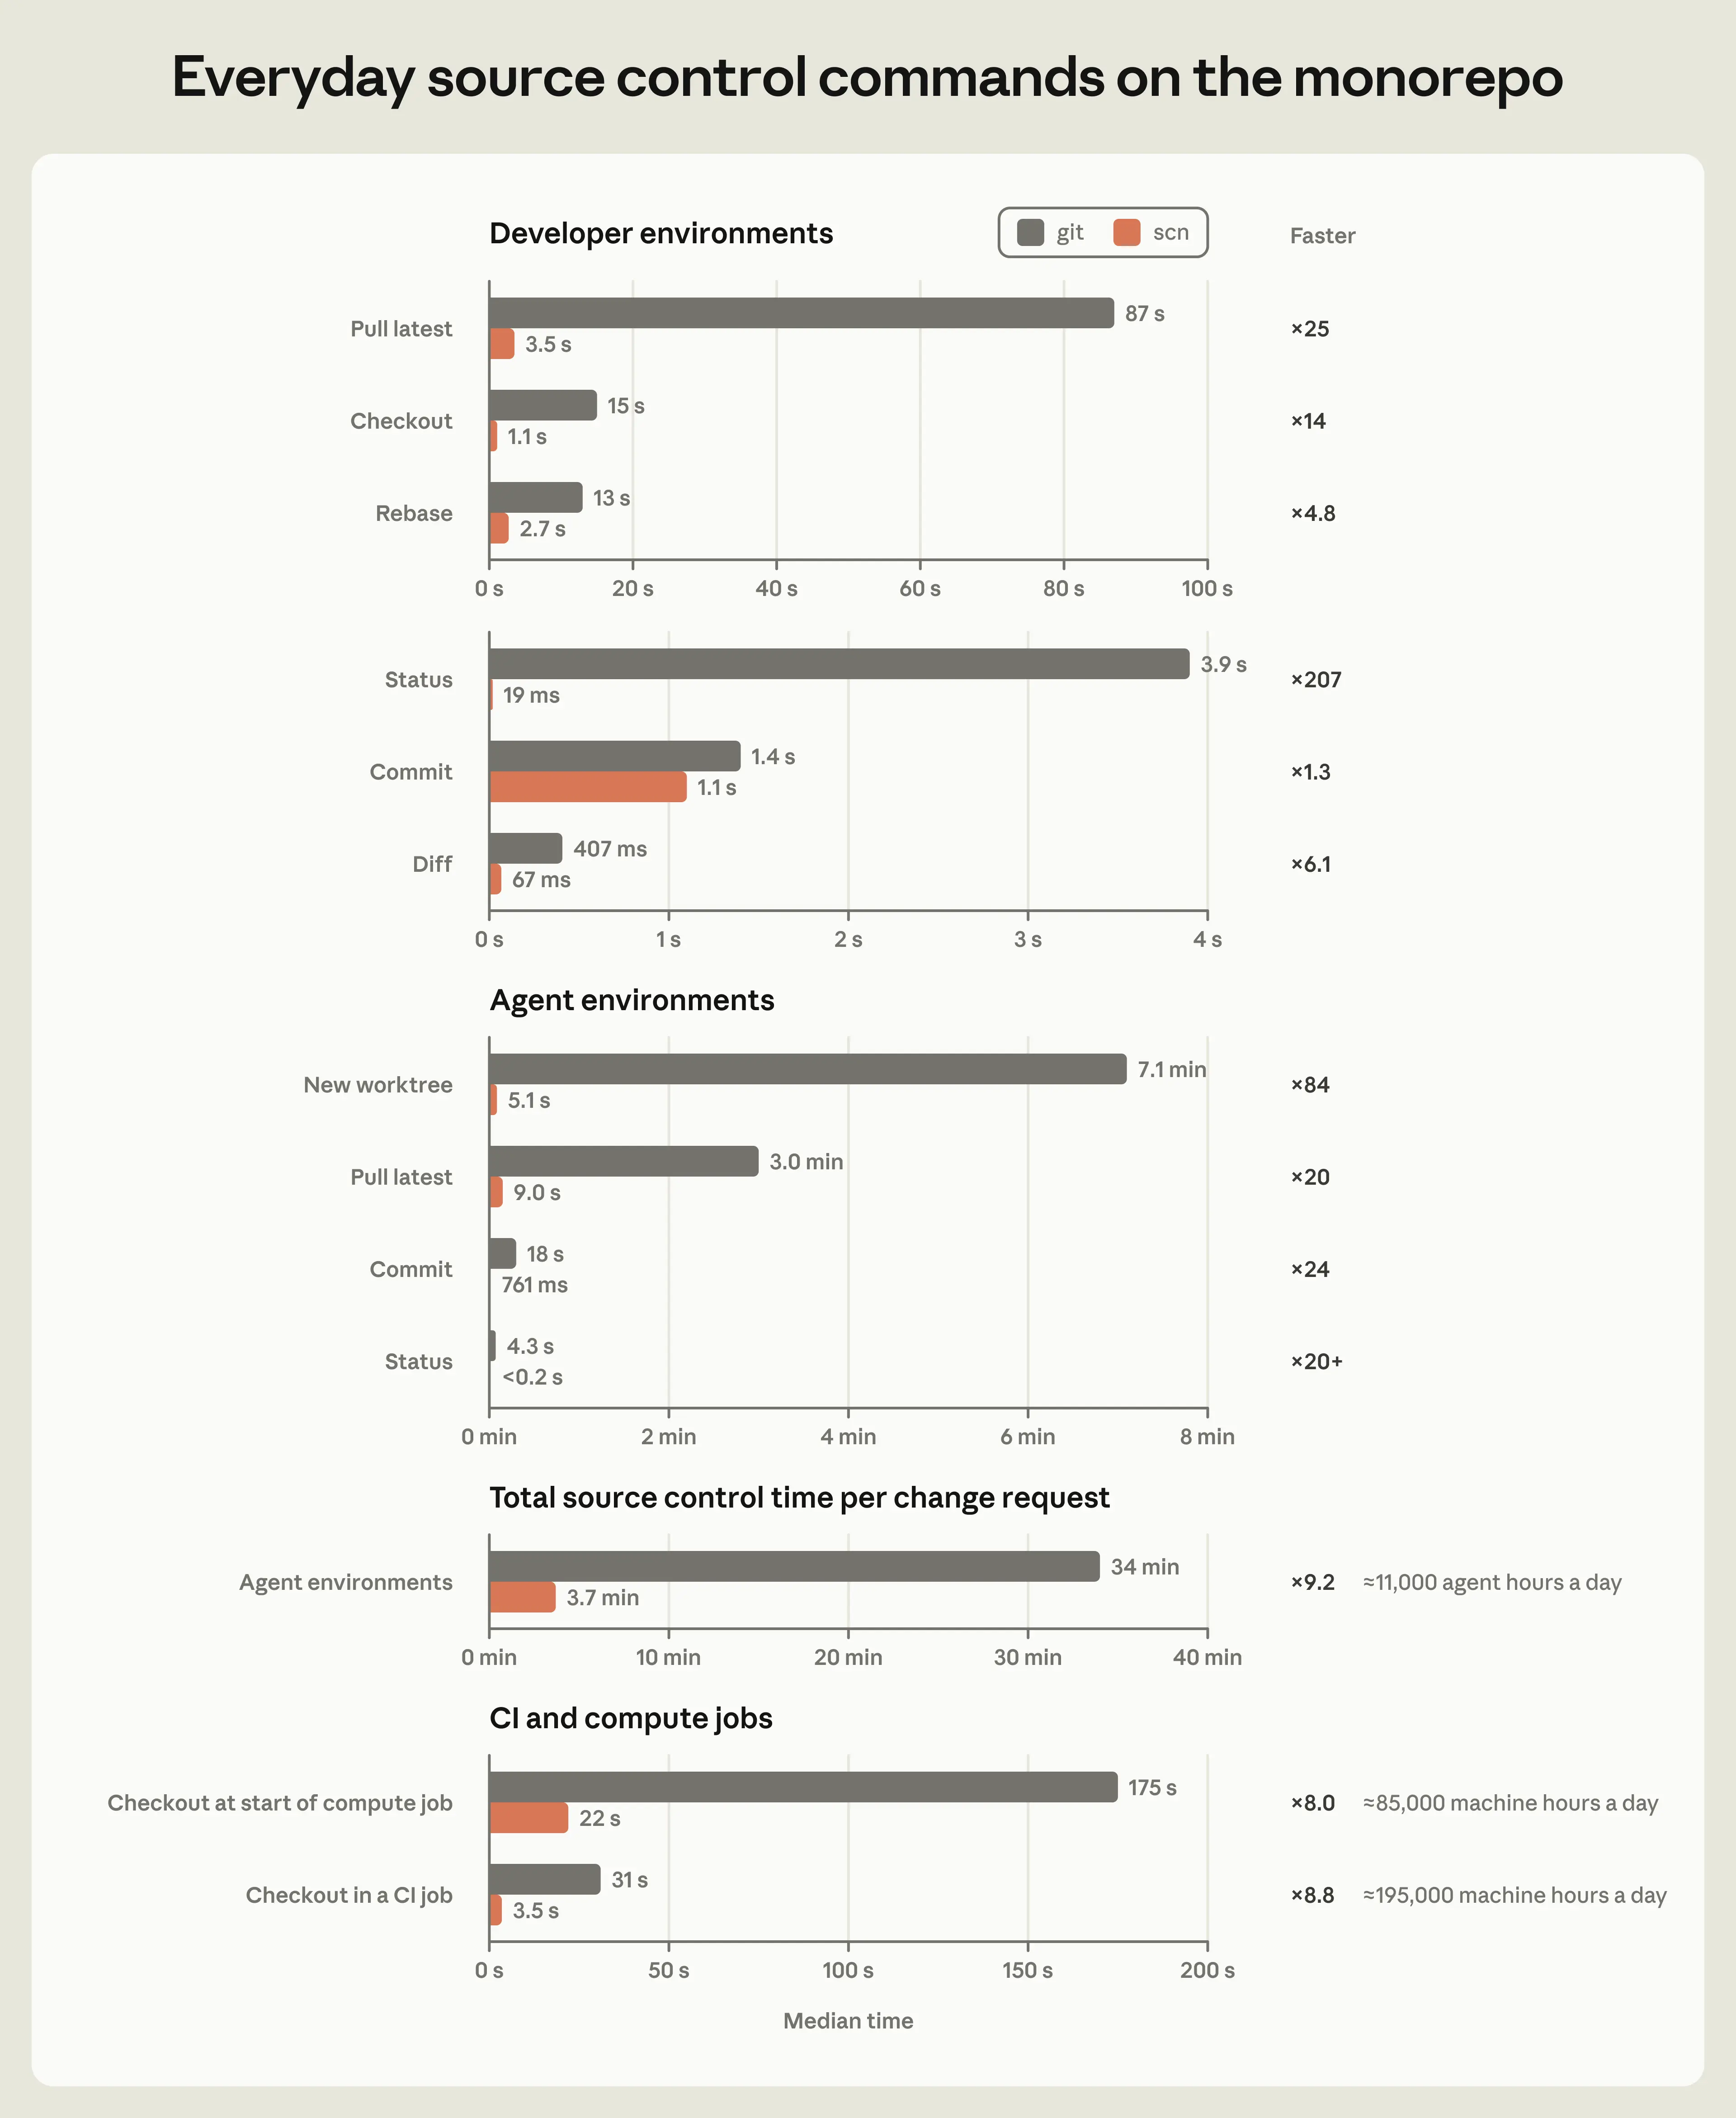
Инфраструктура Scion по требованиям к процессору и памяти в 200 раз компактнее прежнего хозяйства зеркал git. Выгрузка кода ускорилась на два порядка – с минут до секунд; один только CI высвободил 25% процессорной ёмкости. Обслуживание репозитория больше не нужно ни клиентам, ни кэшам.
По медианным значениям с графиков Anthropic, разворачивание кода в начале CI-задачи занимает 3,5 секунды против 31 секунды в git – по оценке компании, это экономит около 195 000 машино-часов в день. Полный цикл работы с исходниками на один запрос на изменение у агентов сократился с 34 до 3,7 минуты, что даёт ещё порядка 11 000 агент-часов в день.
Как это построили
Scion, инструмент ревью Antique и полдюжины сопутствующих сервисов построила команда из семи человек; миграция заняла пять месяцев. Всё это время объём ежедневных слияний продолжал расти и увеличился в 10 раз.
Claude была не только нагрузкой, но и строителем. Первый прототип конвейера, переносившего данные из git в Scion, инженеры в основном написали сами и считали его хорошим. Ранняя внутренняя версия Claude Mythos Preview переписала его целиком без дополнительных указаний: новая версия потребляла в 20 раз меньше памяти и работала в 4 раза быстрее, сохранив все неявные правила порядка загрузки и работы со структурами данных.
Роль инженеров сместилась к замыслу. Они по-прежнему ревьюят каждое изменение, но смотрят на намерение правки, а не на каждую строку. Частая задача – сказать Claude «нет»: агенты иногда нарушают ключевые ограничения системы ради шаблона, которого вообще не следовало допускать. Например, несколько систем пытались выяснить, когда изменение попало в главную ветку, линейным чтением журнала коммитов вместо запроса к инструменту ревью. Приносила проблемы и внутренняя практика соревновательного ревью, где модели ищут слабые места в работе друг друга: она порой оказывалась близорукой, и Claude добавляла избыточные проверки и сложность в ответ на гипотетические опасения.
Пересмотрена и классическая практика слияний. Глобальную блокировку репозитория в очереди слияний на этом масштабе воспроизвести не получилось: что означает CI, когда сотни или тысячи изменений вливаются, пока тесты ещё идут? Вместо этого ставка на автоматическое тестирование после слияния и перед деплоем. Параллельные изменения действительно могут конфликтовать, но, по наблюдению команды, Claude обычно чинит такие конфликты быстрее, чем люди успевают их найти.
Где Scion подходит, а где нет
Scion – не замена git для общего случая. Авторы подчёркивают: описанные идеи имеют смысл только для по-настоящему огромных монорепозиториев – с десятками тысяч инженеров или множеством агентов, активно пишущих код. К тому же Anthropic уникальна в готовности тратить на внутренние задачи больше токенов, чем реалистично потратил бы любой другой бизнес: это одновременно и рабочая необходимость, и способ проверять возможности Claude.
Поделиться системой целиком сложно и практически: Scion сильно расходится с git, миграция означала бы замену всего жизненного цикла разработки – ревью, поиска по коду, CI, – а внутренние версии этих компонентов сильно кастомизированы. Собрать публичную версию «для всех», по мнению авторов, не было бы полезно.
В Anthropic ожидают, что подобные проблемы станут распространёнными в ближайшие шесть–12 месяцев, – это прогноз компании, – и предлагают развивать серверную сторону git, а не мигрировать: платформы могли бы дать полноценные серверные API для вопросов о репозитории, пересмотреть протокол согласования при выгрузке и лучше состыковать существующие функции частичной выгрузки. Git-серверу, по их словам, необязательно работать так же, как git-клиенту.