SpaceXAI представила Grok 4.7. Она построена на новой, более крупной базовой модели, чем Grok 4.6, и прошла более длинный прогон обучения с подкреплением на более тяжёлой смеси задач, смещённой в сторону проблем, на решение которых уходят многие часы. По словам компании, модель дольше держится на трудных задачах, аккуратнее проверяет саму себя и лучше управляется с длинным контекстом; кроме того, её натренировали нативно понимать харнесс Grok Bot — программную обвязку, через которую модель общается с пользователем, — что улучшило разговорные задачи и общую работу со знаниями. Подзаголовок анонса обещает «вдвое большую скорость за половину цены» сопоставимых моделей, при этом сам Grok 4.7 обслуживается по той же цене и скорости, что Grok 4.6.
Цены не изменились: $2 за миллион входных токенов и $6 за миллион выходных, кэш-попадания — $0,50 за миллион, как и у Grok 4.6. Контекстное окно — 500 тысяч токенов, без изменений относительно предшественника. Уровень рассуждений настраивается от low до xhigh; Artificial Analysis оценивала модель именно на xhigh — наивысшем. Дополнительно есть «быстрая» версия с удвоенной скоростью аутпута по удвоенной цене, а средняя стоимость одной задачи Intelligence Index в замерах Artificial Analysis составила $3,74.
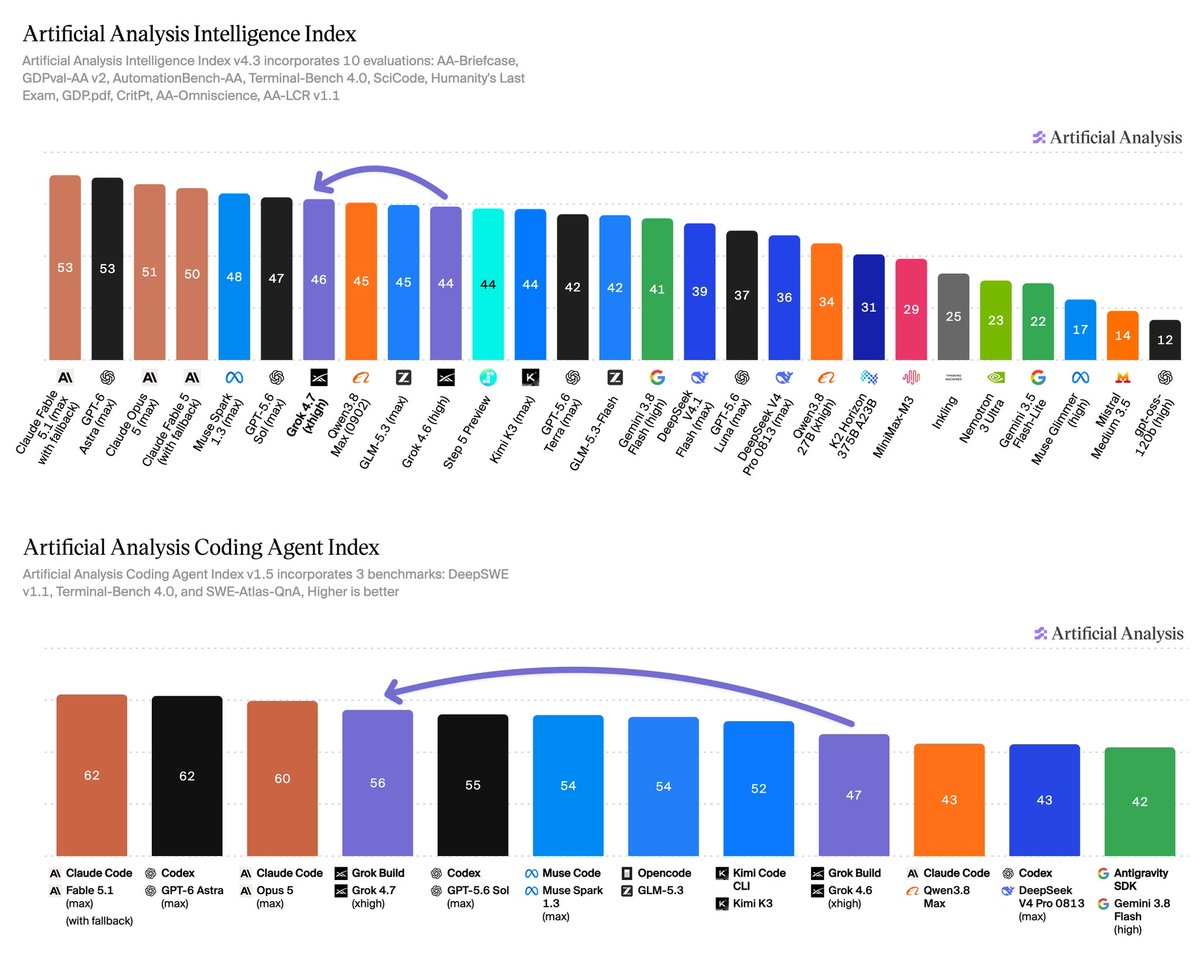
По оценке Artificial Analysis, Grok 4.7 набирает 46 баллов в Intelligence Index — на 2 балла больше, чем Grok 4.6, — что выводит SpaceXAI в четвёрку ведущих ИИ-лабораторий по этому рейтингу. Вне агентной работы со знаниями картина сдержаннее: на остальных задачах индекса модель в целом на уровне предшественницы — прибавила на Terminal-Bench 4.0 (+4,5 п.п.) и GDP.pdf (+3,0 п.п.), но просела на AA-LCR (−3,7 п.п.) и AutomationBench-AA (−1,1 п.п.).
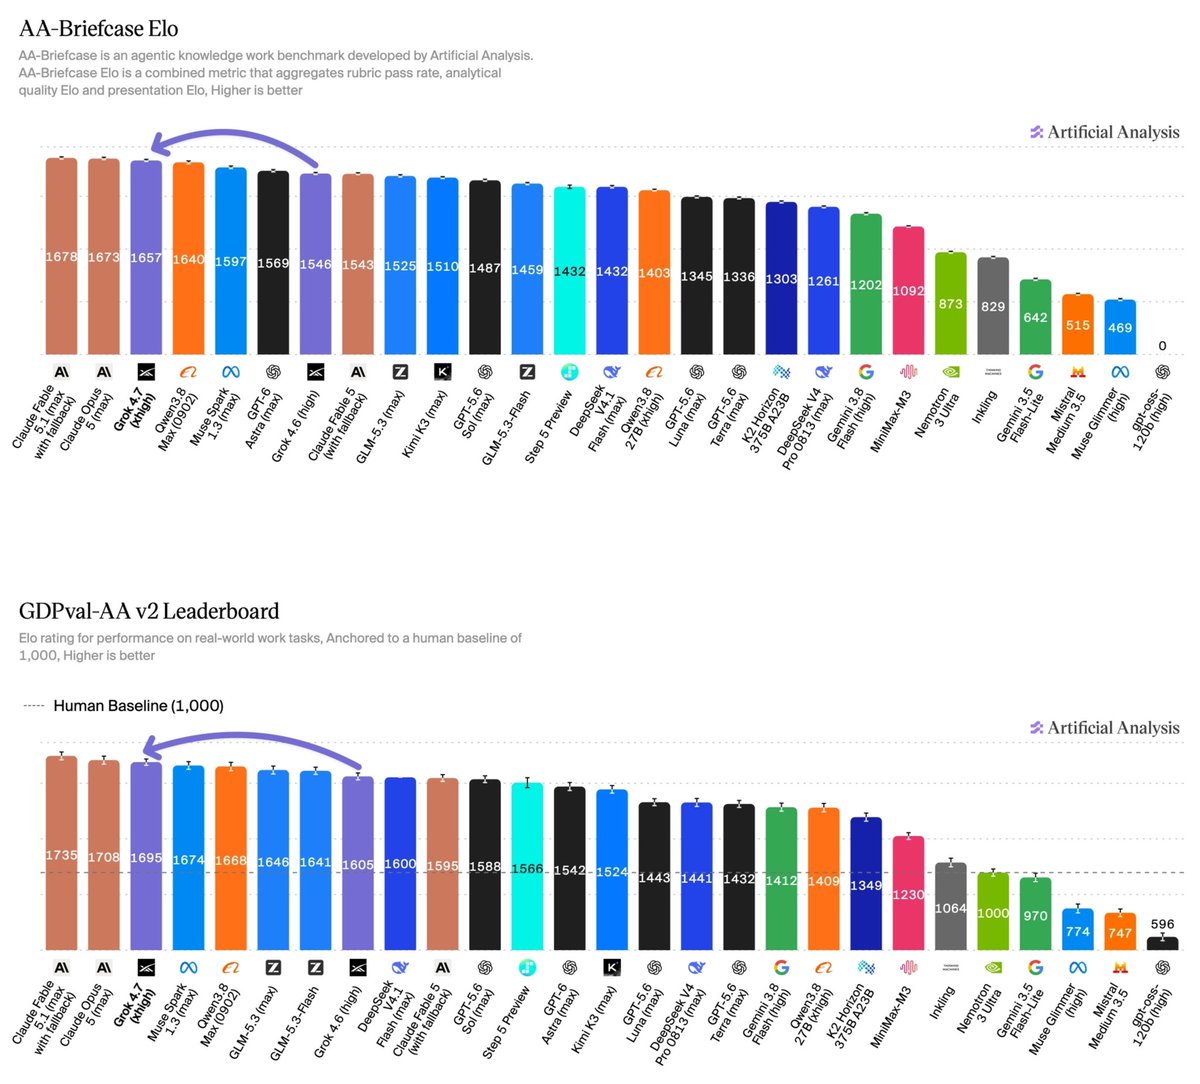
Главный прирост пришёлся на агентную работу со знаниями, где моделям поручают задачи уровня юристов, медсестёр и финансовых аналитиков. На AA-Briefcase — приватном бенчмарке Artificial Analysis для многочасовой офисной работы — Grok 4.7 (xhigh) добавила 111 очков рейтинга Elo (шкалы, где модели сравнивают попарно) к результату Grok 4.6 (high) и встала вплотную к фронтиру: у лидирующих Claude Fable 5.1 и Claude Opus 5 — 1678 и 1673 Elo. Прирост обеспечило аналитическое качество — 1994 Elo против 1690 у предшественницы, тогда как качество подачи слегка снизилось (1499 против 1519); бенчмарк дополнительно проверяет, выполнены ли все требования задачи — от самого анализа до запрошенных артефактов. На GDPval-AA, где от модели ждут практических рабочих продуктов — документов, таблиц, слайдов, — Grok 4.7 набрала 1695 Elo против 1605 у Grok 4.6; по описанию лидерборда, он якорится к человеческой базовой линии в 1000, а у Claude Fable 5.1 — 1735. SpaceXAI отдельно отмечает, что модель стала лучше создавать документы и презентации и на обоих бенчмарках сопоставима с другими фронтирными моделями.
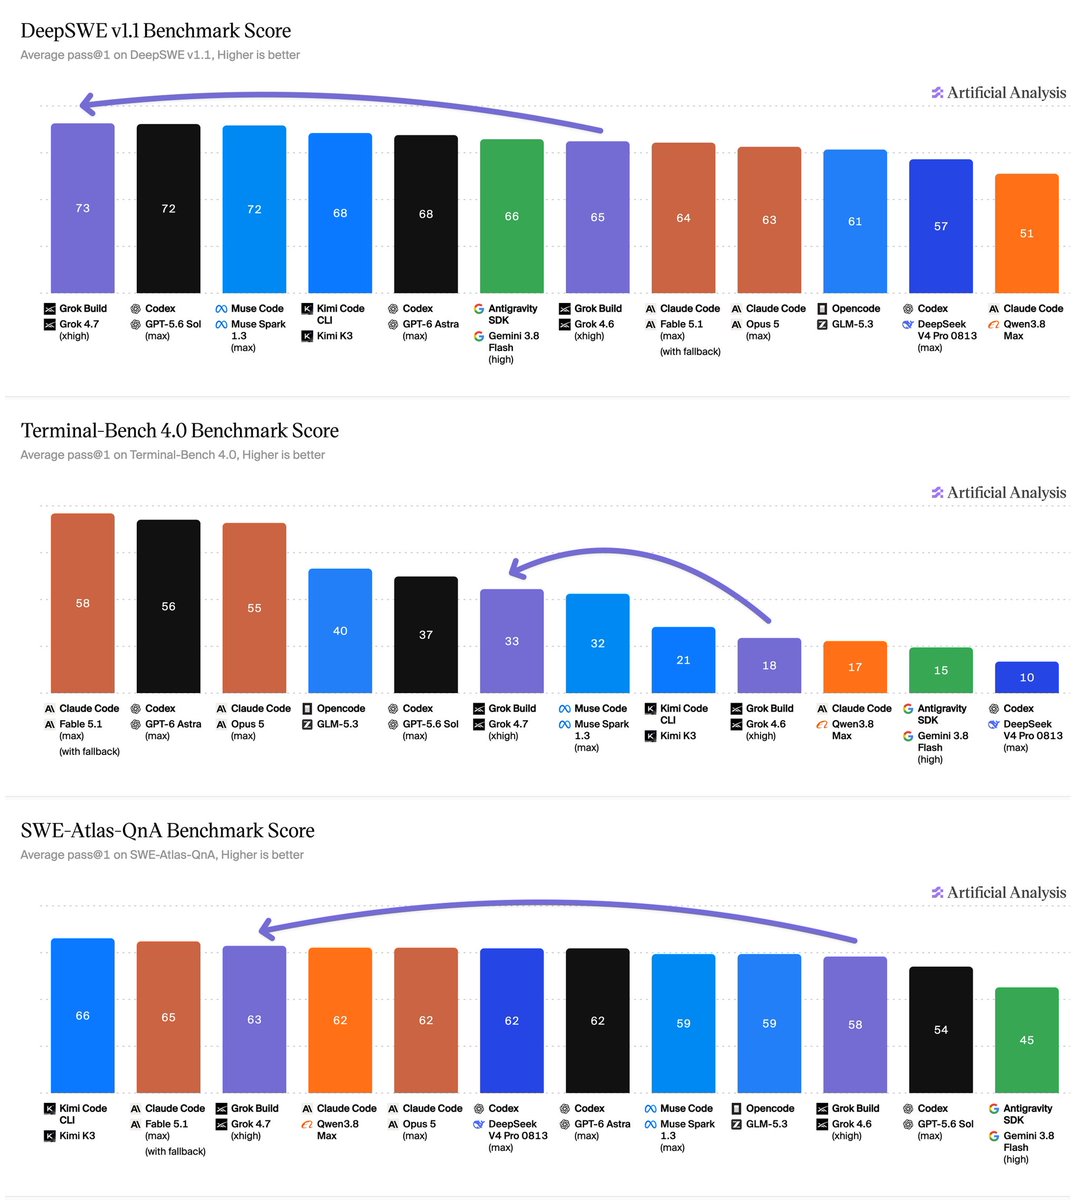
В кодинге Grok 4.7 (xhigh) в связке с Grok Build — фирменным кодинг-агентом SpaceXAI — набирает 56 баллов в Coding Agent Index, на 9 больше, чем Grok 4.6 (xhigh), и обходит связку GPT-5.6 Sol с Codex.
На CursorBench 4.0, нагружающем модели долгими кодинг-задачами, Grok 4.7 (xhigh) набирает 46,3% при средней цене $6,01 за задачу — по данным SpaceXAI, это фронтир по соотношению качества и цены: Claude Opus 5 (max) показывает 46,6% при $11,95, Claude Fable 5.1 (max) — 51,8% при $17,28, GPT-5.6 Sol (max) — 41,7% при $8,23.
Самые показательные строки: в электротехнике Grok 4.7 обходит GPT-5.6 Sol более чем на 24 п.п., в юридической работе её результат почти в восемь раз выше, чем у GPT-5.6 Sol, а Terminal-Bench 4.0 вырос вдвое относительно Grok 4.6. Единственная дисциплина из таблицы, где Grok 4.7 уступает обоим конкурентам, — клинические рассуждения: модель прибавила, но осталась позади GPT-5.6 Sol и Fable 5.1.
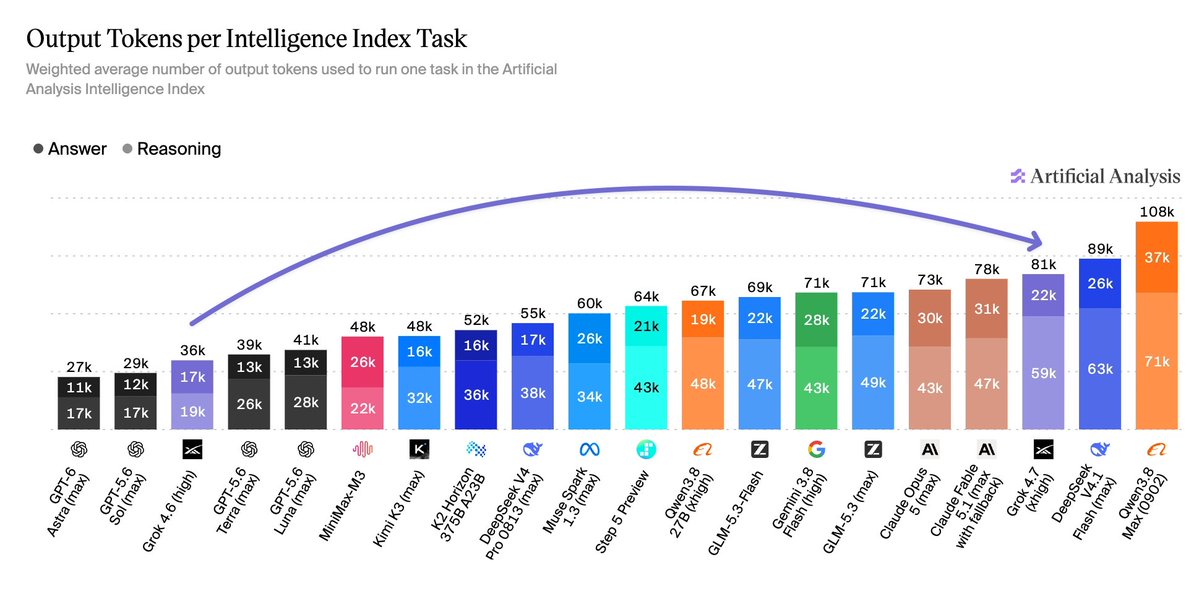
За приросты приходится платить токенами: Grok 4.7 (xhigh) тратит в среднем около 81 тысячи выходных токенов на задачу Intelligence Index — против 36 тысяч у Grok 4.6 и 27 тысяч у GPT-6 Astra (max), то есть на 125% и 196% больше; у Muse Spark 1.3 (max) — 60 тысяч. Среднее время декодирования — около 7,1 минуты на задачу, а скорость аутпута на длинных промптах — примерно 188 токенов/с; на странице модели Artificial Analysis при этом указано другое значение — 39,5 токена/с.
В знаниевом зачёте AA-Omniscience частота галлюцинаций снизилась до 29% против 34% у Grok 4.6 (high), точность практически не изменилась (47% против 48%), а общий индекс вырос с 30 до 32.
Безопасность — отдельная тема анонса. Grok 4.7 построена на полностью новом стеке защит и, по данным SpaceXAI, показала лучшие результаты среди протестированных компанией моделей по корректности отказов и стойкости к джейлбрейкам. В областях двойного применения — кибербезопасности и биологической работе — она, как утверждается, лидирует сразу по двум осям: полезности для легитимных задач и безопасным отказам на опасных. Модель возглавляет биосейфти-бенчмарк LatchBio с результатом 62,4%, а на HackerBench v0.3 — бенчмарке SpaceXAI на рискованные и вредоносные кибер-задачи — пропускает лишь 3,3% рискованных промптов двойного применения, почти не блокируя легитимную работу специалистов по безопасности. Доступ к red-team-возможностям Grok 4.7 для оборонных исследований компания начала выдавать по приглашениям избранным киберпартнёрам.
Grok 4.7 уже доступна в Cursor и Grok Build, а также через Grok API, сторонние кодинг-харнесы, модельные роутеры и облачные платформы. Попробовать модель можно бесплатно в Grok Build.
Источники
- Introducing Grok 4.7
- Grok 4.7 (xhigh) — Intelligence, Performance & Price Analysis | Artificial Analysis
- Artificial Analysis в X: Grok 4.7 — 46 баллов Intelligence Index и топ-4 лабораторий
- Artificial Analysis в X: детали AA-Briefcase и GDPval-AA
- Artificial Analysis в X: результаты Coding Agent Index
- Artificial Analysis в X: расход выходных токенов
- Artificial Analysis в X: скорость и время на задачу
- Artificial Analysis в X: галлюцинации в AA-Omniscience
- Artificial Analysis в X: полная разбивка Intelligence Index
- Artificial Analysis в X: ссылка на полный отчёт