Google представила две новые модели живого голосового диалога: Gemini 3.8 Live и Gemini 3.8 Live Extended Thinking. Компания называет их своими самыми продвинутыми live-моделями: они рассуждают почти в реальном времени, выполняют задачи в фоне и поддерживают разговор, не разрывая его. Логан Килпатрик описал релиз как новые SOTA-модели среди live-аудио с сочетанием «frontier price + performance».
Модели разделены по ролям. Gemini 3.8 Live создана для масштаба и экономической эффективности: плавный диалог, разговорный интеллект и умение опираться на визуальный вход. Extended Thinking ориентирована на сложные задачи с многошаговым рассуждением. В посте для разработчиков обе описаны как нативные speech-to-speech модели (понимают и генерируют речь напрямую) и как более компактная альтернатива каскадным схемам, где распознавание речи, текстовая модель и синтез соединены цепочкой.
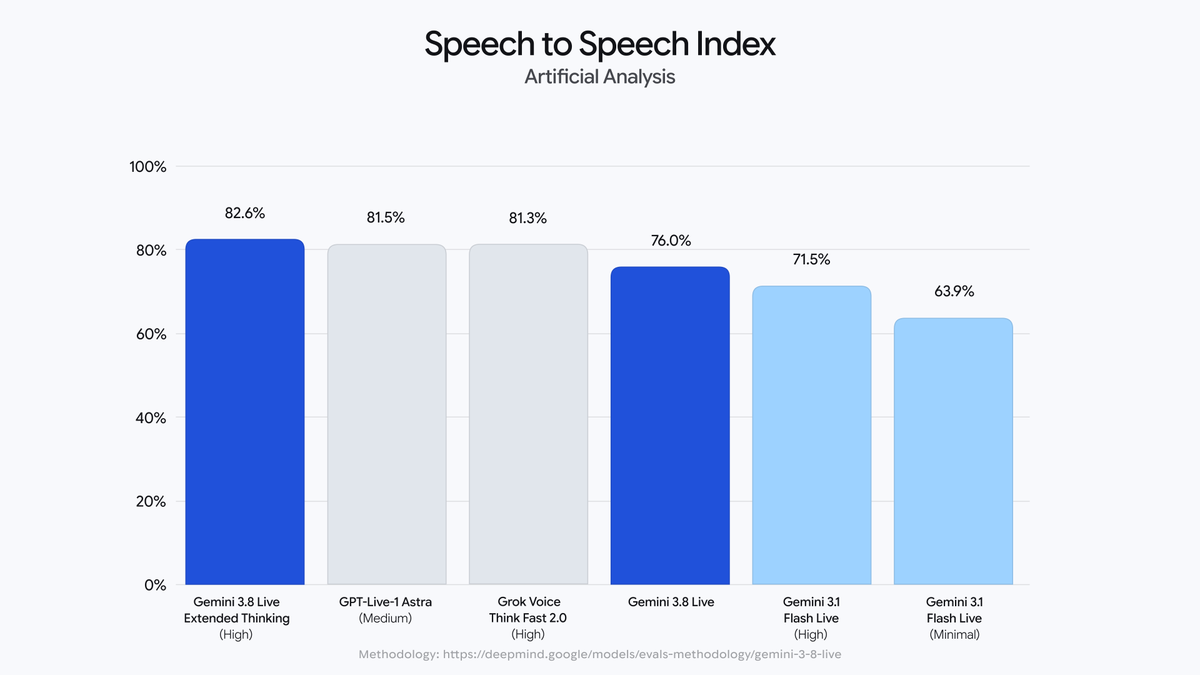
По данным Artificial Analysis, вариант Extended Thinking (High) дебютировал на первом месте индекса Speech to Speech с результатом 82.6% — это независимо подтверждает и сама Artificial Analysis. На опубликованных Google диаграммах ближайшие конкуренты уступают: GPT-Live-1 Astra (Medium) — 81.5%, Grok Voice Think Fast 2.0 (High) — 81.3%, базовая Gemini 3.8 Live — 76.0%. В агентных задачах (τ-Voice) Extended Thinking набирает 68.6% — тоже первое место по версии Artificial Analysis — против 67.9% у GPT-Live-1 Astra; базовая 3.8 Live — 30.1%. На банковском бенчмарке Sierra (лидерборд τ³-Banking) — 35.1% против 32.0% у той же Astra. Рассуждения на аудио: 97.7% на Big Bench Audio. Базовая 3.8 Live занимает второе место в Speech Agent Arena, а на EVA-Bench от ServiceNow модели, по словам Google, сдвигают границу Парето, балансируя точность выполнения и качество диалога.
Что умеют модели
Gemini 3.8 Live обрабатывает визуальный вход почти в реальном времени — собеседник может просто показать то, о чём говорит. Модель автоматически распознаёт и переключается между 97 поддерживаемыми языками посреди разговора, а вызовы инструментов и API выполняет в фоне, продолжая диалог, пока задача завершается.
Для разработчиков Google отдельно перечисляет: асинхронный function calling — фоновые вызовы API при продолжающемся стриминге аудио; точный парсинг буквенно-цифровых данных вроде кодов подтверждения, номеров претензий и технических данных; согласованное произношение с акцентами на 97+ языках; инкрементальные обновления контента — слияние реального аудио со структурированными данными для контекстных ответов.
Extended Thinking умеет рассуждать и говорить одновременно: на сложных многошаговых задачах она вставляет ранние вербальные сигналы вроде «Let me check that...», а затем в реальном времени комментирует прогресс фоновой работы. Глубина thinking конфигурируется под задачу.
Цены и доступность
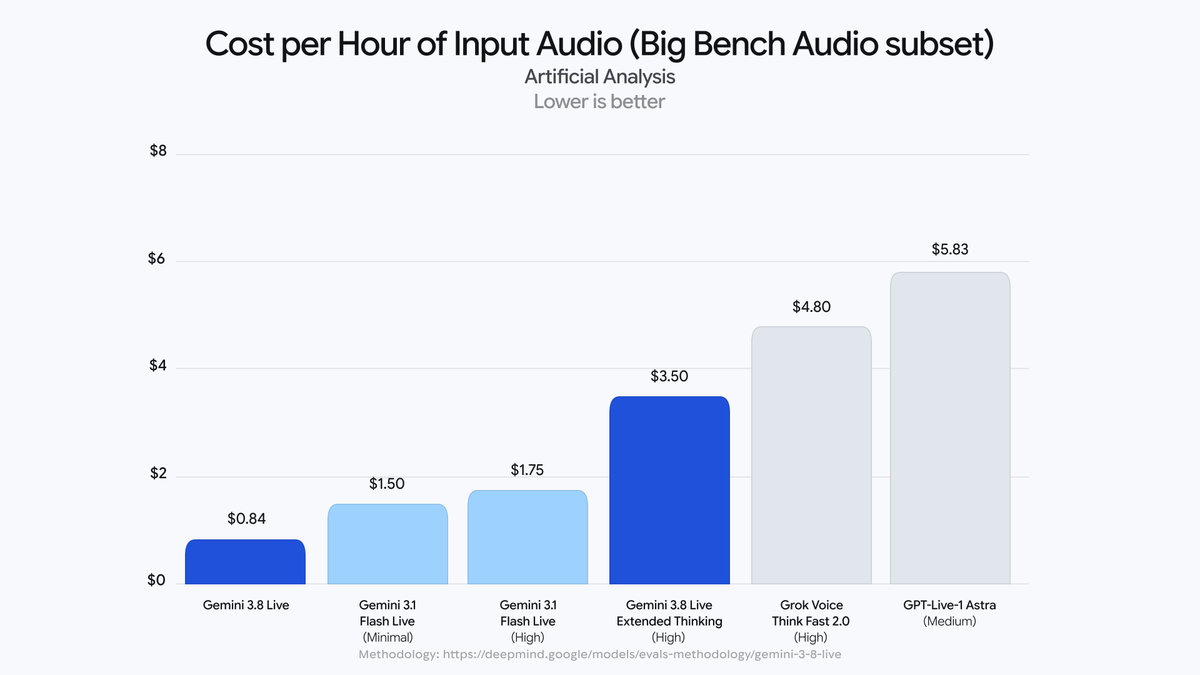
Через Live API обе модели стоят $0.005 за минуту аудио-инпута и $0.018 за минуту аутпута. На диаграмме Artificial Analysis (стоимость часа входного аудио на подмножестве Big Bench Audio, ниже — лучше) базовая 3.8 Live обходится в $0.84, Extended Thinking — в $3.50, против $4.80 у Grok Voice Think Fast 2.0 (High) и $5.83 у GPT-Live-1 Astra (Medium).
- Разработчикам: обе модели — в Gemini API через Google AI Studio; попробовать можно на ai.studio/live, примеры приложений выложены на GitHub.
- Энтерпрайзу: private preview в Gemini Enterprise; 3.8 Live скоро появится в Gemini Enterprise for Customer Experience, Extended Thinking — ещё и у бизнес-клиентов Google Workspace.
- Обычным пользователям: 3.8 Live — в Search Live; Extended Thinking — в Gemini Live, в Docs для подписчиков Google AI Pro и Ultra, а также в Gmail и Keep для всех подписчиков Google AI.
Весь сгенерированный моделями звук помечается невоспринимаемым на слух водяным знаком SynthID, встроенным прямо в аудиовыход, — так AI-контент остаётся обнаруживаемым.
Разработчикам: Live API и полный аудио-набор
Через Gemini Live API модели уже доступны на платформах Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel и Vision Agents — они берут на себя инфраструктуру real-time медиастриминга, оставляя разработчикам работу над пользовательским опытом. Salesforce, Genspark и Lumeris, по словам Google, отмечают задержку, плавность и tool-calling новых моделей.
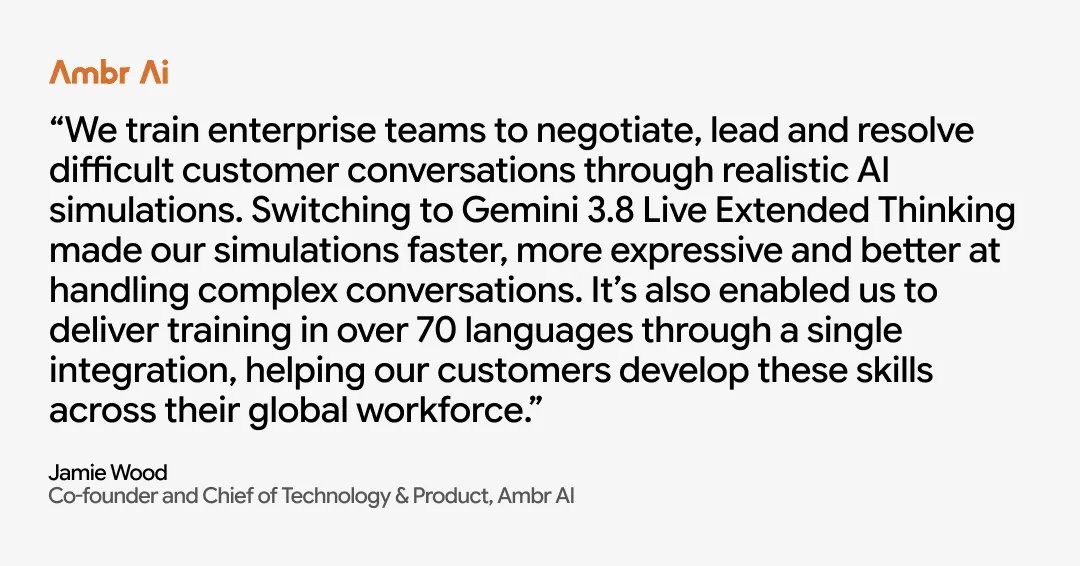
Партнёры приводят конкретные сценарии. В ServiceNow (цитата в материалах запуска) хвалят выполнение задач, смену реплик и выразительность интонаций. В Ambr AI — сервисе симуляций переговоров для корпоративных команд — сообщают, что переход на 3.8 Live Extended Thinking сделал симуляции быстрее, выразительнее и надёжнее в сложных диалогах, а обучение удалось развернуть более чем на 70 языках через одну интеграцию.
Рядом с новинками Google показывает остальной аудио-конвейер. Gemini 3.5 Transcribe, выпущенная в прошлом месяце, транскрибирует 85+ языков со средней ошибкой на уровне слова (WER) 4.0% в стриминге и 2.6% вне его; модель сама переключает языки внутри и между предложениями, принимает пользовательский словарь до 1 000 терминов и умеет выдавать «причёсанные» транскрипты без слов-паразитов. Через Interactions API она размечает аудиофайлы длиной до часа с таймстампами и метками спикеров. Замыкают набор Gemini 3.5 Live Translate (устный перевод на 70+ языков), Gemini 3.1 Flash TTS и Lyria 3.5 для генерации музыки.
Источники
- Google DeepMind — анонс Gemini 3.8 Live и 3.8 Live Extended Thinking (X)
- Google AI Studio — Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking (X)
- Google AI — анонс Gemini Audio-моделей (X)
- Логан Килпатрик — «новые SOTA live audio models» (X)
- Google AI Studio — тизер двух live-моделей (X)
- Google AI Studio — Build real-time voice applications with Gemini 3.8 Live and 3.5 Transcribe (X)
- Artificial Analysis — независимое подтверждение результатов бенчмарков (X)